こんにちは、ぼりたそです!
今回は、NumPyで合計・平均・標準偏差を求める方法と、集計する方向を指定するaxisについて解説します。
「列ごとの平均を出したいのに、行ごとの平均になってしまった」という経験はありませんか?NumPyでは、集計する関数に加えて、どの軸に沿って値をまとめるかを指定することが大切です。
この記事では、以下のポイントを解説します。
np.sum():合計を求めるnp.mean():平均を求めるnp.std():ばらつきを表す標準偏差を求めるaxis=0とaxis=1:列ごと・行ごとに集計するkeepdims=Trueとddofの役割
それでは順番に確認していきましょう!
NumPyで配列を集計するには?
配列に対するa + 10のような計算は、各要素に同じ処理を行います。一方、集計は、複数の値をまとめて合計や平均などを求める操作です。
まずはNumPyを読み込みます。以降のコードは、この読み込みを実行した状態を前提とします。
import numpy as np今回は、整数や小数を要素に持ち、欠損値を含まない配列を使います。
np.sum():要素の合計を求める
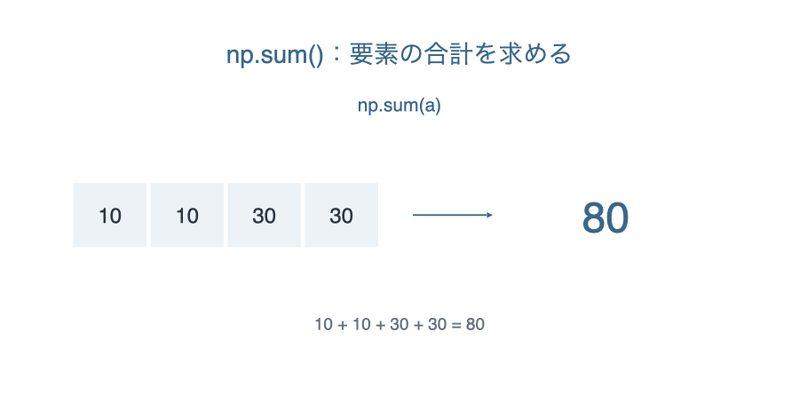
np.sum()は、配列の要素の合計を求める関数です。
np.sum(配列)例えば、次の4つの値を合計してみましょう。
a = np.array([10, 10, 30, 30])
print(np.sum(a))

# 実行結果:
# 80
10 + 10 + 30 + 30を計算した結果の80が得られます。
np.sum(a)は、a.sum()と書くこともできます。この記事では、関数名がわかりやすいnp.sum(a)の形を使います。
np.mean():要素の平均を求める
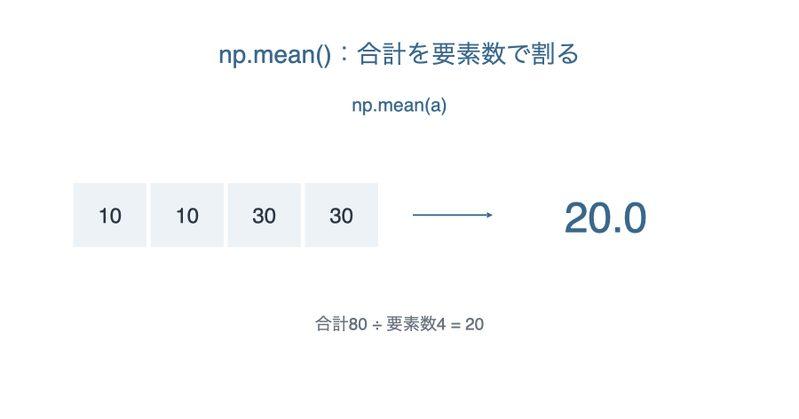
np.mean()は、算術平均を求める関数です。算術平均は、値の合計を要素数で割って求めます。
a = np.array([10, 10, 30, 30])
print(np.mean(a))

# 実行結果:
# 20.0
合計80を要素数4で割るため、平均は20になります。元の配列が整数でも、平均は通常、浮動小数点数で返されます。
np.std():要素のばらつきを求める
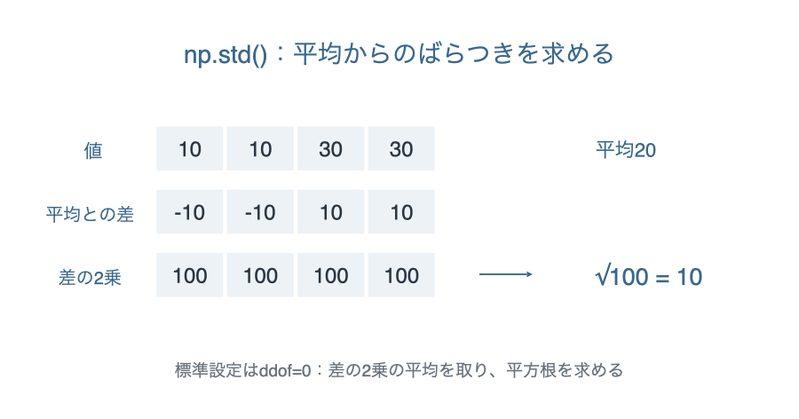
np.std()は、標準偏差を求める関数です。標準偏差は、値が平均の周りでどれくらいばらついているかを表します。
a = np.array([10, 10, 30, 30])
print(np.std(a))

# 実行結果:
# 10.0この例の平均は20で、各値と平均の差は[-10, -10, 10, 10]です。標準設定では、次の順に計算します。
- 各値から平均を引く
- 差を2乗し、その平均を求める
- 平方根を求める
差を2乗すると、すべて100になります。その平均100の平方根を取るため、標準偏差は10です。
すべての値が同じ配列では、ばらつきがないため標準偏差は0になります。
print(np.std(np.array([20, 20, 20, 20])))

# 実行結果:
# 0.0
標準偏差は元データと同じ単位で表せます。ただし、数値のスケールが異なるデータ同士で、標準偏差の大小だけを比較する場合は注意しましょう。
axisとは?2次元配列の行と列を確認する
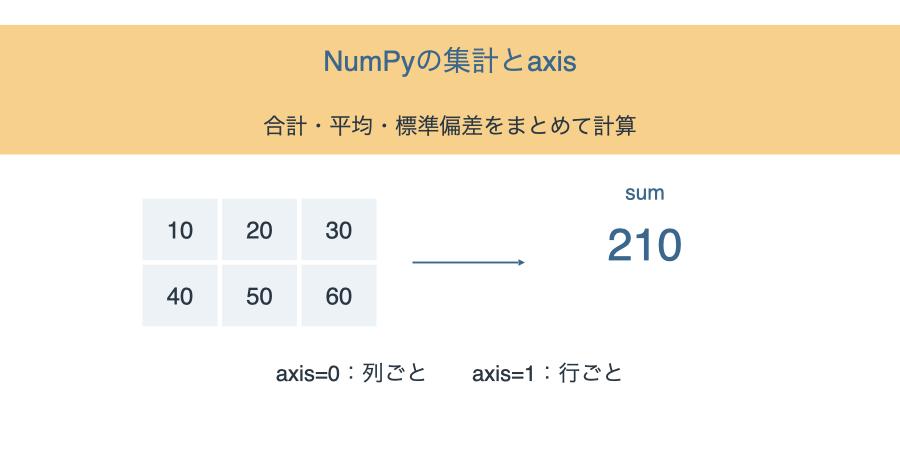
ここからは、次の2行3列の配列を使います。
data = np.array([
    [10, 20, 30],
    [40, 50, 60]
])

print(data.shape)
print(np.sum(data))

# 実行結果:
# (2, 3)
# 210shapeの(2, 3)は、行数2・列数3を表します。
ここでaxisについて説明します。
axisは、配列の「軸」を表します。軸とは、配列の中で値が並んでいる方向のことです。
行と列を持つ2次元配列には、縦方向と横方向の2つの軸があります。NumPyでは、それぞれを番号で区別します。
axis=0:縦方向の軸axis=1:横方向の軸
np.sum()やnp.mean()では、axisを使って、どの方向に並ぶ値をまとめて集計するかを指定します。
集計で指定するのは、値をまとめて縮める軸です。axisを省略すると、標準では配列全体を集計します。上の合計210は、6つの値をすべて足した結果です。
axis=0:列ごとに集計する
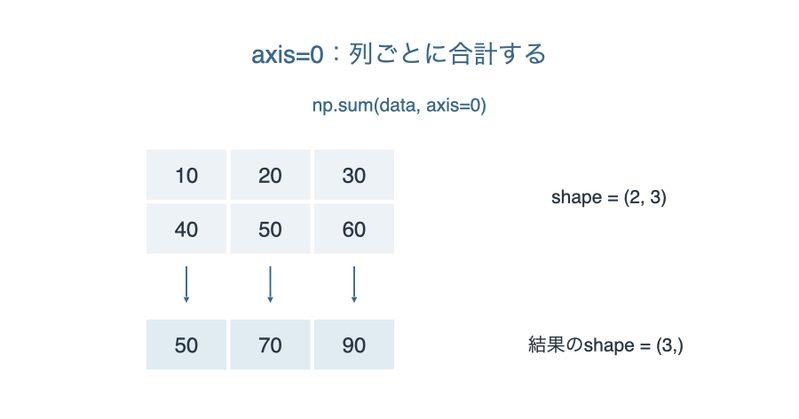
axis=0を指定すると、列ごとに値を集計することになります。
print(np.sum(data, axis=0))
print(np.mean(data, axis=0))
print(np.std(data, axis=0))

# 実行結果:
# [50 70 90]
# [25. 35. 45.]
# [15. 15. 15.]合計は、1列目が10 + 40 = 50、2列目が20 + 50 = 70、3列目が30 + 60 = 90です。
集計により行がなくなり、列ごとの結果が3つ残ります。結果の形状は(3,)で、1行3列の2次元配列ではありません。
axis=1:行ごとに集計する
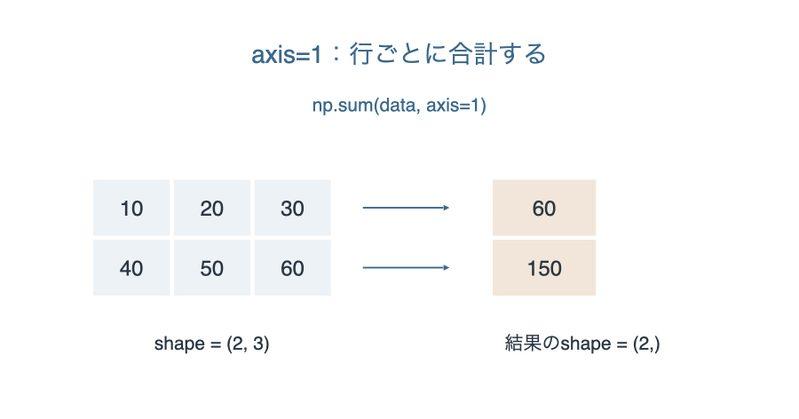
axis=1を指定すると、行ごとに値を集計します。
print(np.sum(data, axis=1))
print(np.mean(data, axis=1))
print(np.round(np.std(data, axis=1), 3))

# 実行結果:
# [ 60 150]
# [20. 50.]
# [8.165 8.165]合計は、1行目が10 + 20 + 30 = 60、2行目が40 + 50 + 60 = 150です。行ごと集計結果が残ります。
np.round(値, 3)は、小数点以下3桁に丸める書き方です。ここでは、標準偏差の表示を読みやすくするために使っています。
axisを省略した場合・0・1の違い
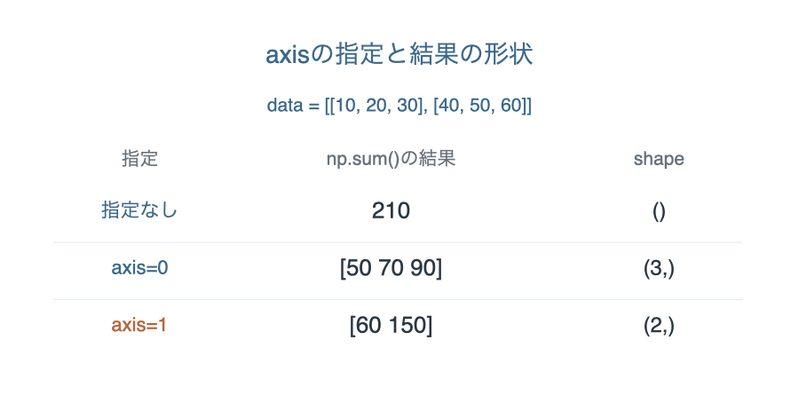
今回のdata.shapeは(2, 3)です。
| 指定 | 合計 | 結果の形状 | まとめる対象 |
|---|---|---|---|
省略/axis=None | 210 | () | 全要素 |
axis=0 | [50 70 90] | (3,) | 各列の値 |
axis=1 | [60 150] | (2,) | 各行の値 |
()は、結果が軸を持たない1つの値であることを表します。
「axis=0は列ごと、axis=1は行ごと」と覚えるだけでなく、指定した軸をまとめ、その軸以外の形状が残ると考えると、結果を確認しやすくなります。
行をサンプル、列を特徴量とするデータなら、特徴量ごとの平均はaxis=0です。例えば、列ごとに異なる測定項目を持つデータを集計するときに使えます。
keepdims=True:集計した軸を長さ1で残す
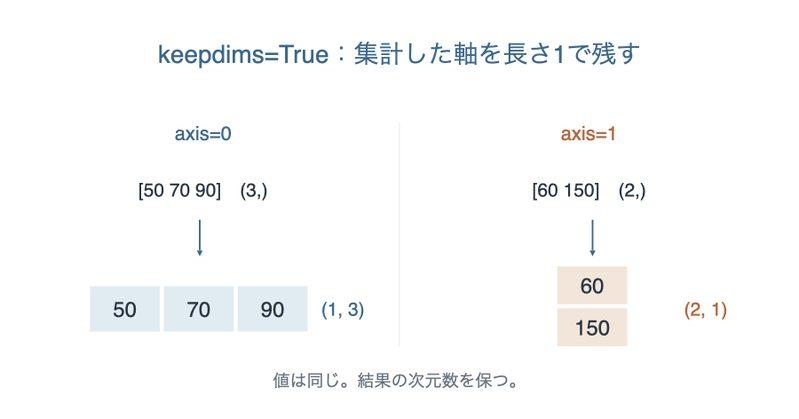
通常の集計では、指定した軸が結果からなくなります。keepdims=Trueを指定すると、その軸を長さ1として残せます。
column_sum = np.sum(data, axis=0, keepdims=True)
row_sum = np.sum(data, axis=1, keepdims=True)

print(column_sum)
print(column_sum.shape)
print(row_sum)
print(row_sum.shape)

# 実行結果:
# [[50 70 90]]
# (1, 3)
# [[ 60]
#  [150]]
# (2, 1)axis=0では(1, 3)、axis=1では(2, 1)になります。集計値は変わらず、結果の形状が変わることがポイントです。
この指定は、集計結果を元の配列と組み合わせて計算するときに役立ちます。形状が異なる配列同士の計算は、ブロードキャストの記事で詳しく解説します。
集計する際の注意点
np.std()は標準で要素数Nで割る
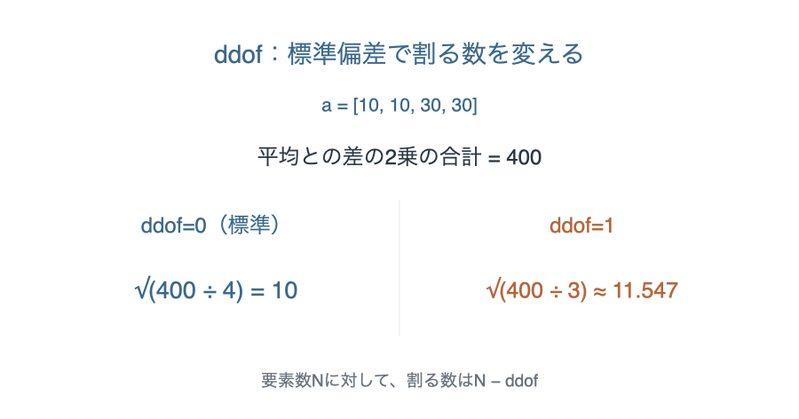
np.std()の標準設定はddof=0です。平均との差の2乗の合計を、集計する要素数Nで割ってから平方根を求めます。
ddof=1とすると、割る数がN - 1になります。
a = np.array([10, 10, 30, 30])

print(np.std(a, ddof=0))
print(np.round(np.std(a, ddof=1), 3))

# 実行結果:
# 10.0
# 11.547この例では、平均との差の2乗の合計が400です。ddof=0なら400 / 4、ddof=1なら400 / 3の平方根を取ります。
ddof=1で求めるのは、不偏分散の平方根に相当する標準偏差です。**標準偏差そのものが不偏推定量になる、という意味ではありません。**用途や比較先に合わせて設定をそろえましょう。また、要素数が1の集計にddof=1を指定すると、割る数が0になるため有限の標準偏差を求められません。
1次元配列にはaxis=1がない
np.array([10, 20, 30])の形状は(3,)で、軸は0だけです。axis=1を指定すると、存在しない軸のためエラーになります。
見た目の横並びだけで判断せず、shapeで次元数を確認しましょう。
NaNを含む配列は別の扱いが必要
欠損値を表すNaNがあると、通常のnp.mean()やnp.std()は、そのNaNを含む集計対象についてnanを返します。NaNを除外して計算する関数や欠損値の補完は、前処理・標準化の記事で扱います。
NumPyを基礎から学びたい方へ
集計方法を覚えると、データの特徴を数値で確認できるようになります。さらに、形状変更やブロードキャストを組み合わせると、集計結果を使った前処理にもつなげられます。
こうした基本操作を体系的に学びたい方向けに、Kindle書籍『機械学習・データ分析のためのNumPy入門 ― 配列操作と数値計算の基本をPythonで学ぶ ―』を執筆しました。
本書では、配列の作成やデータの取り出し、条件抽出、集計、ブロードキャストなどを、コード例と演習問題を通じて学べる構成にしています。
「axisの指定を自分で考えてコードを書けるようになりたい」「NumPyの基本を順番に身につけたい」という方は、ぜひチェックしてみてください!
まとめ
今回は、NumPyで合計・平均・標準偏差を求める方法と、axisの考え方を解説しました。
| 書き方 | 用途・特徴 |
|---|---|
np.sum(a) | 全要素の合計 |
np.mean(a) | 全要素の平均 |
np.std(a) | 全要素の標準偏差。標準はddof=0 |
np.sum(data, axis=0) | 2次元配列の列ごとの合計 |
np.sum(data, axis=1) | 2次元配列の行ごとの合計 |
keepdims=True | 集計した軸を長さ1で残す |
集計では「どの関数を使うか」と「どの軸をまとめるか」をセットで考えることがポイントです。
まずはaxisの指定を変えて、結果の値とshapeがどう変わるかを確認してみてください!