こんにちは、ぼりたそです!
今回は、NumPyの配列を扱う際に知っておきたい、コピーとビューの違いについて解説します。
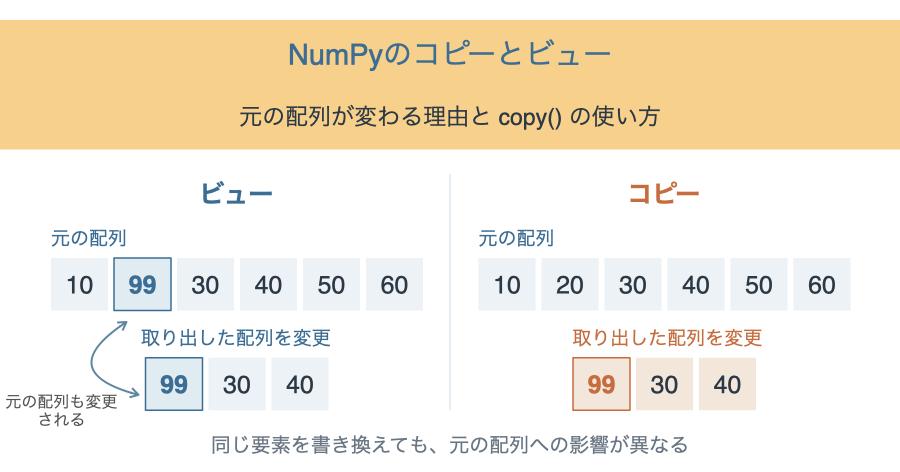
NumPyでは、配列の一部を取り出した際に、元の配列とデータを共有している場合があります。そのため、取り出した配列の値を変更すると、元の配列まで変わることがあります。
元のデータを残したまま計算や前処理を行うためにも、コピーとビューの違いはぜひ覚えておきたいですね。
この記事では、以下のポイントを解説します。
- 代入:同じ配列を別の変数名で参照する
- ビュー:元の配列とデータを共有する
- コピー:元の配列とは独立したデータを作成する
- 2次元配列の行や列を取り出した場合の注意点
- データを共有しているか確認する方法
それでは順番に確認していきましょう!
コピーとビューとは?
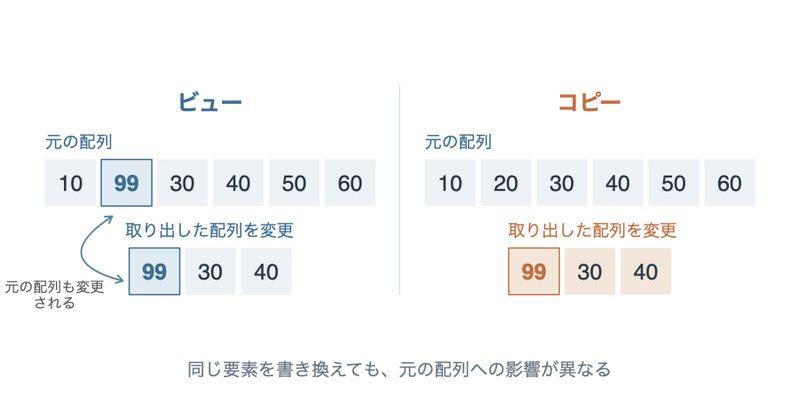
NumPyでは、配列から別の配列を作成したときに、データが複製される場合と、元のデータを共有する場合があります。
データを複製して作成した配列を「コピー」、元の配列とデータを共有する別の配列を「ビュー」と呼びます。
コピーでは、取り出した配列の要素を変更しても元の配列は変わりません。一方、ビューでは、共有している要素への変更が元の配列にも反映されます。
例えば、配列の一部分だけを取り出して値を修正する場合、この違いによって元のデータが残るかどうかが変わります。
NumPyを使用するには、最初にライブラリを読み込みます。
import numpy as np以降のコードは、この読み込みを実行した状態を前提とします。また、今回は整数を要素に持つ通常のNumPy配列を使用します。
各操作の結果を比較しやすいように、基本となる配列は同じ数値で作成し直してから使用します。直前のコードに続けて実行する場合は、その都度説明します。
代入:同じ配列を別の変数名で参照する
まず、配列を別の変数に代入した場合の動きを確認してみましょう。
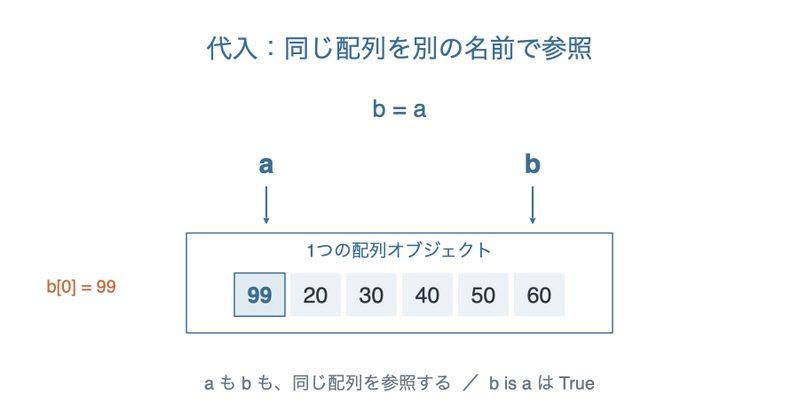
b = aと記述すると、変数bでも配列aを参照できるようになります。ただし、この操作だけで配列がコピーされるわけではありません。
例えば、bの先頭の値を99に変更してみます。
a = np.array([10, 20, 30, 40, 50, 60])
b = a

b[0] = 99

print(a)
print(b)
print(b is a)

# 実行結果:
# [99 20 30 40 50 60]
# [99 20 30 40 50 60]
# Trueb[0]を変更したところ、a[0]も99になりました。
これは、aとbが同じ配列を参照しているためです。変数名は異なりますが、どちらの名前を使っても同じ配列の要素を書き換えます。
isは、2つの変数が同じオブジェクトを参照しているかを確認する演算子です。ここではTrueなので、aとbは同じ配列を参照しています。
ビュー:元の配列とデータを共有する
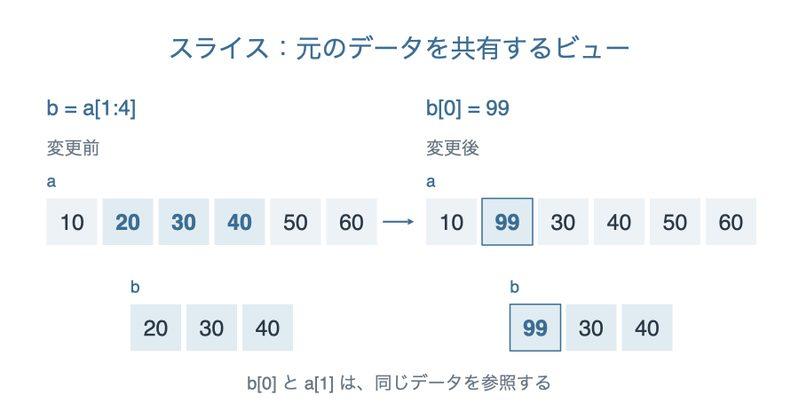
次に、スライスで配列の一部分を取り出してみましょう。
スライスは、配列から指定した範囲の要素をまとめて取り出すための書き方です。
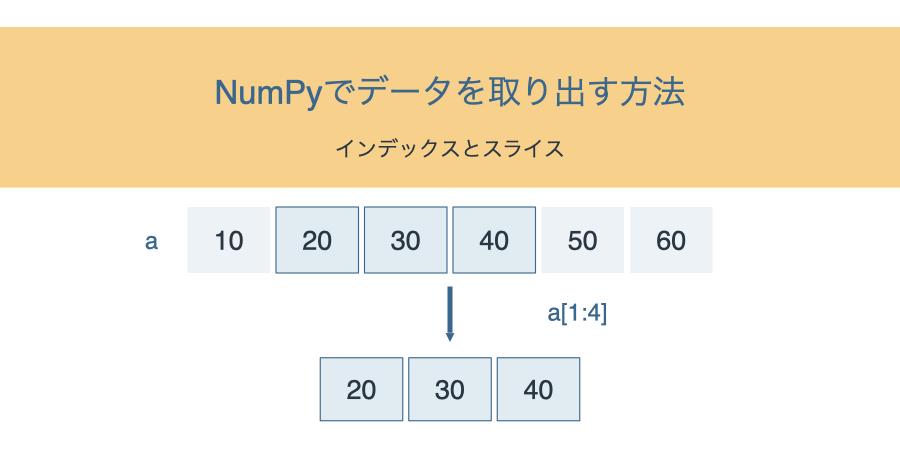
配列[開始:終了]インデックスは0から始まり、終了位置は含まれません。例えば、a[1:4]では、インデックス1から3までの値を取り出せます。
取り出した配列の先頭を変更すると、どのようになるでしょうか。
a = np.array([10, 20, 30, 40, 50, 60])
b = a[1:4]

print(b)

b[0] = 99

print(b)
print(a)

# 実行結果:
# [20 30 40]
# [99 30 40]
# [10 99 30 40 50 60]bの先頭の要素は、元の配列ではa[1]に対応します。そのため、b[0] = 99によって、a[1]も99になりました。
ここで注意したいのは、スライスで取り出した配列は、元の配列とデータを共有するビューになるという点です。
今回の例では、b[0]とa[1]が同じデータを参照しているため、どちらも99になっています。
なお、ビューは別の配列オブジェクトなので、単純な代入とは異なり、次の結果はFalseです。
print(b is a)

# 実行結果:
# False別の配列オブジェクトであっても、データは共有できるという点がポイントです。
元の配列からの変更もビューに反映される
ビューでは、元の配列の値を変更した場合も、対応する要素に変更が反映されます。
直前のコードに続けて、a[2]を77に変更してみましょう。
a[2] = 77

print(a)
print(b)

# 実行結果:
# [10 99 77 40 50 60]
# [99 77 40]a[2]はb[1]に対応するため、bにも変更が反映されます。
このように、ビューは取り出した時点の値を保存したものではなく、元の配列のデータを共有していることがわかります。
view()で配列全体のビューを作成する
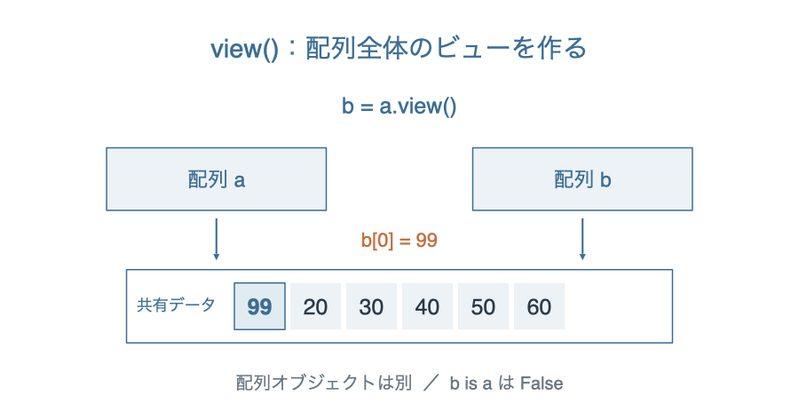
配列全体のビューを作成する場合は、view()を使用できます。
基本的な書き方は次のとおりです。
配列.view()例えば、配列aのビューを作成し、先頭の値を変更してみましょう。
a = np.array([10, 20, 30, 40, 50, 60])
b = a.view()

b[0] = 99

print(a)
print(b)
print(b is a)

# 実行結果:
# [99 20 30 40 50 60]
# [99 20 30 40 50 60]
# Falseaとbは別の配列オブジェクトですが、要素のデータを共有しています。
スライスを使う場合は自動的にビューが作られるため、毎回view()を付ける必要はありません。
copy():元の配列と独立したコピーを作成する
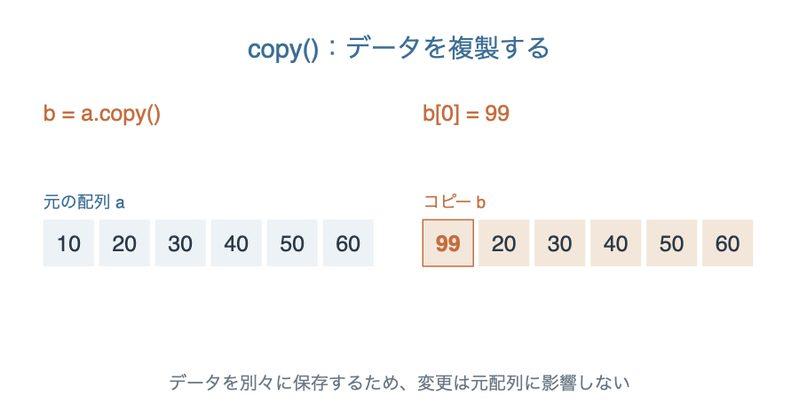
元の配列を残したまま値を変更したい場合は、copy()を使用します。
copy()は、配列のデータを複製して、独立した配列を作成するメソッドです。
配列.copy()例えば、配列aをコピーし、コピーした配列の先頭を99に変更してみましょう。
a = np.array([10, 20, 30, 40, 50, 60])
b = a.copy()

b[0] = 99

print(a)
print(b)

# 実行結果:
# [10 20 30 40 50 60]
# [99 20 30 40 50 60]b[0]を書き換えても、a[0]は10のままです。copy()によって、データが別の場所に複製されたためです。
元データを残して前処理を試したいときや、変更前後の値を比較したいときに役立ちます。
スライスで取り出した範囲をコピーする
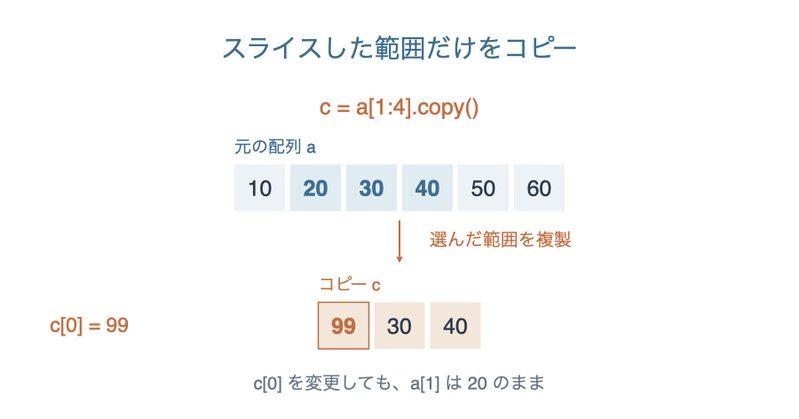
配列全体ではなく、必要な範囲だけをコピーすることもできます。
その場合は、スライスの後ろに.copy()を付けます。
配列[開始:終了].copy()例えば、インデックス1から3までの値をコピーしてみましょう。
a = np.array([10, 20, 30, 40, 50, 60])
c = a[1:4].copy()

c[0] = 99

print(a)
print(c)

# 実行結果:
# [10 20 30 40 50 60]
# [99 30 40]a[1:4]で対象範囲を選び、copy()でその部分のデータを複製しています。
取り出した部分だけを処理するなら、配列全体をコピーする必要はありません。
ビューとコピーの違い
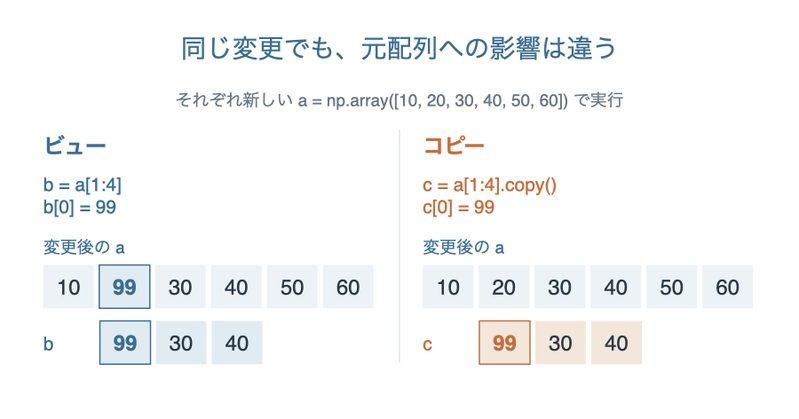
スライスとcopy()は、どちらも必要な値を持つ配列を作成できますが、元の配列との関係が異なります。
同じ範囲を取り出して、先頭の値を99に変更した場合を比較してみましょう。どちらも、新しく作ったa = np.array([10, 20, 30, 40, 50, 60])に対して実行した結果です。
| 作り方 | 変更する操作 | 変更後の取り出した配列 | 変更後の元配列a |
|---|---|---|---|
b = a[1:4] | b[0] = 99 | [99 30 40] | [10 99 30 40 50 60] |
c = a[1:4].copy() | c[0] = 99 | [99 30 40] | [10 20 30 40 50 60] |
取り出した配列だけを表示すると、結果は同じです。しかし、元の配列への影響は異なります。
元のデータを変更したくない場合は、要素を書き換える前にコピーを作りましょう。 書き換えた後でコピーしても、元の値には戻りません。
2次元配列:取り出した行や列を変更する
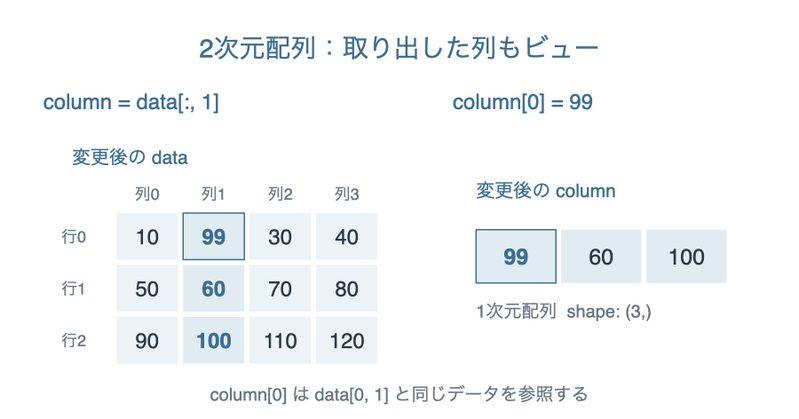
次に、行と列を持つ2次元配列で確認してみましょう。
2次元配列でも、整数とスライスを使って行や列を取り出すと、元の配列とデータを共有するビューになります。
次の例では、data[:, 1]で2列目を取り出します。:はすべての行、1は列のインデックスを表します。
data = np.array([
    [10, 20, 30, 40],
    [50, 60, 70, 80],
    [90, 100, 110, 120]
])

column = data[:, 1]
column[0] = 99

print(column)
print(data)

# 実行結果:
# [ 99  60 100]
# [[ 10  99  30  40]
#  [ 50  60  70  80]
# [ 90 100 110 120]]column[0]を書き換えたことで、元の配列の1行目・2列目にあたるdata[0, 1]も99になっています。
なお、取り出したcolumnは1次元配列なので、print()では横一列に表示されます。
元の配列を残して列の値を変更したい場合は、コピーを作ってから処理します。
data = np.array([
    [10, 20, 30, 40],
    [50, 60, 70, 80],
    [90, 100, 110, 120]
])

column = data[:, 1].copy()
column[0] = 99

print(column)
print(data)

# 実行結果:
# [ 99  60 100]
# [[ 10  20  30  40]
#  [ 50  60  70  80]
# [ 90 100 110 120]]行の場合も同じです。例えば、data[0, :]は1行目のビュー、data[0, :].copy()は1行目の独立したコピーになります。
np.shares_memory():データの共有を確認する
最後に、2つの配列がデータを共有しているか確認する方法を紹介します。
np.shares_memory()は、2つの配列の要素が、メモリ上の保存領域を共有しているか調べる関数です。
np.shares_memory(配列1, 配列2)例えば、代入・スライス・view()・copy()で用意した配列について確認してみましょう。
a = np.array([10, 20, 30, 40, 50, 60])
b = a
v = a[1:4]
w = a.view()
c = a.copy()

print(np.shares_memory(a, b))
print(np.shares_memory(a, v))
print(np.shares_memory(a, w))
print(np.shares_memory(a, c))

# 実行結果:
# True
# True
# True
# FalseTrueなら保存領域に重なりがあり、Falseなら重なりがありません。
isとnp.shares_memory()では、確認する内容が異なります。
| 作り方 | 対象の配列 is a | np.shares_memory(a, 対象の配列) |
|---|---|---|
b = a | True | True |
v = a[1:4] | False | True |
w = a.view() | False | True |
c = a.copy() | False | False |
isがFalseだからといって、データも独立しているとは限りません。データの共有を調べたい場合は、np.shares_memory()を使いましょう。
コピーとビューを扱う際の注意点
a[:]もコピーではなくビューになる
a[:]は、配列全体をスライスする書き方です。すべての要素を選んでも、データが複製されるわけではありません。
数値を要素に持つPythonのリストでは、values[:]で作ったリストの要素を別の値に置き換えても、元のリストは変わりません。NumPy配列のスライスと同じ感覚で扱わないようにしましょう。
配列全体を独立させたい場合は、a.copy()と書きます。
整数のリストで取り出すとコピーになる
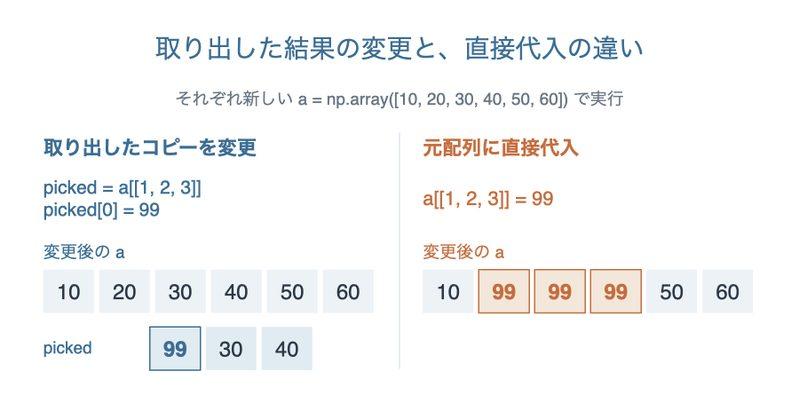
一方、a[[1, 2, 3]]のように、インデックスをリストでまとめて指定する方法では、取り出した結果はコピーになります。この取り出し方は「高度なインデックス指定」の一種です。
a = np.array([10, 20, 30, 40, 50, 60])
picked = a[[1, 2, 3]]

picked[0] = 99

print(picked)
print(a)

# 実行結果:
# [99 30 40]
# [10 20 30 40 50 60]a[1:4]とa[[1, 2, 3]]は、どちらも最初は[20 30 40]を取り出しますが、元配列との関係が異なります。
また、条件式で取り出すa[a > 30]もコピーになります。条件抽出の詳しい書き方は、別の記事で扱います。
ただし、取り出した結果を変数に保存して変更する場合と、元配列に直接代入する場合は区別してください。
a = np.array([10, 20, 30, 40, 50, 60])
a[[1, 2, 3]] = 99

print(a)

# 実行結果:
# [10 99 99 99 50 60]この書き方は、aの指定した位置に直接99を代入しています。そのため、元の配列が変わります。
変数への再代入と要素の書き換えは異なる
ビューを作った後でも、変数そのものに別の配列を代入した場合は、元の配列を書き換えません。
a = np.array([10, 20, 30, 40, 50, 60])
b = a[1:4]

b = np.array([7, 8, 9])

print(a)
print(b)

# 実行結果:
# [10 20 30 40 50 60]
# [7 8 9]
b = ...は、変数bが参照する先を変える操作です。b[0] = ...やb[:] = ...のように、現在の配列の要素へ代入する操作とは異なります。
コピーにはデータの複製が必要
コピーを作ると、その分の保存領域とデータを複製する処理が必要になります。
大きな配列を扱う場合は、すべてを機械的にコピーするのではなく、「元データを残したいか」「どの範囲を変更するか」を考えて使い分けましょう。
なお、ここまでの説明は通常の数値配列を前提としています。リストなどを要素として格納するdtype=objectの配列では、copy()だけで要素の中身まで複製されるわけではない点に注意してください。
NumPyを基礎から学びたい方へ
今回は、NumPyのコピーとビューの違いについて紹介しました。
NumPyをデータ分析や機械学習で活用するためには、今回のコピーやビューに加えて、配列を使った計算や条件抽出、集計なども理解しておくと役立ちます。
そこで、NumPyの基本操作を体系的に学びたい方向けに、Kindle書籍『機械学習・データ分析のためのNumPy入門 ― 配列操作と数値計算の基本をPythonで学ぶ ―』を執筆しました。
本書では、配列の作成やインデックス・スライス、条件抽出、集計、ブロードキャストなどを、コード例と演習問題を通じて学べる構成にしています。
「説明を読むだけでなく、自分でコードを書いて理解を深めたい」「データ分析や機械学習に向けてNumPyの基本を身につけたい」という方は、ぜひチェックしてみてください!
まとめ
今回は、NumPyのコピーとビューの違いについて解説しました。
今回紹介した書き方をまとめると、次のようになります。
| 書き方 | 用途・特徴 |
|---|---|
b = a | 同じ配列を別の変数名で参照する |
a[1:4] | 指定した範囲のビューを作成する |
a.view() | 配列全体のビューを作成する |
a.copy() | 配列全体の独立したコピーを作成する |
a[1:4].copy() | 指定した範囲の独立したコピーを作成する |
np.shares_memory(a, b) | 2つの配列がデータを共有しているか確認する |
ビューでは元の配列とデータを共有し、コピーではデータが複製されます。元のデータを残して処理したい場合は、値を変更する前にcopy()を使用することがポイントです。
また、b = aと代入しただけでは、独立した配列は作成されません。変数名が異なっていても、元の配列に変更が反映される場合があることを覚えておきましょう。
まずは今回紹介したコードを実際に動かして、ビューとコピーで元の配列への影響がどのように変わるのかを確認してみてください!