こんにちは、ぼりたそです!
今回は、NumPyの配列から必要なデータを取り出す方法について解説します。
NumPyでは、配列の中から1つの値を取り出すだけでなく、範囲を指定したり、特定の行や列をまとめて取り出したりできます。
これらの操作は、データ分析や機械学習で必要なデータを選ぶ際の基本となりますので、ぜひ覚えておきたいですね。
この記事では、以下のポイントを解説します。
- インデックス:位置を指定して1つの値を取り出す
- スライス:範囲や間隔を指定して取り出す
- 2次元配列:特定の要素・行・列を取り出す
- 整数とスライスで指定した場合の形状の違い
- データを取り出す際の注意点
それでは順番に確認していきましょう!
NumPyの配列からデータを取り出すには?
NumPyの配列では、配列名の後ろに[]を付け、その中に取り出す位置や範囲を指定します。
例えば、「3番目の値を取り出す」「最初の3つを取り出す」といった操作ができます。1次元配列の指定方法は、Pythonのリストと基本的に同じです。
NumPyを使用するには、最初にライブラリを読み込みます。
import numpy as np以降のコードは、この読み込みを実行した状態を前提とします。
配列の作成方法については、前回の記事で解説していますので、必要に応じて参考にしてみてください。

インデックス:位置を指定して1つの値を取り出す
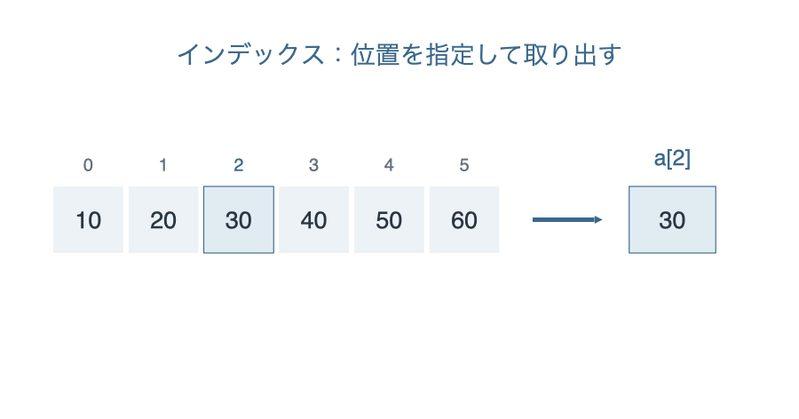
インデックスは、配列の要素がどの位置にあるかを表す番号です。
ここで注意したいのは、インデックスは1ではなく0から始まるという点です。先頭の要素が0、2番目が1、3番目が2となります。
基本的な書き方は次のとおりです。
配列[インデックス]例えば、次の配列から先頭と3番目の値を取り出してみましょう。
a = np.array([10, 20, 30, 40, 50, 60])

print(a[0])
print(a[2])

# 実行結果:
# 10
# 30a[0]では先頭の10、a[2]では3番目の30が取り出されています。
このように、取り出したい要素の位置をインデックスで指定できます。以降の1次元配列の例でも、この配列aを使用します。
負のインデックスで後ろから取り出す
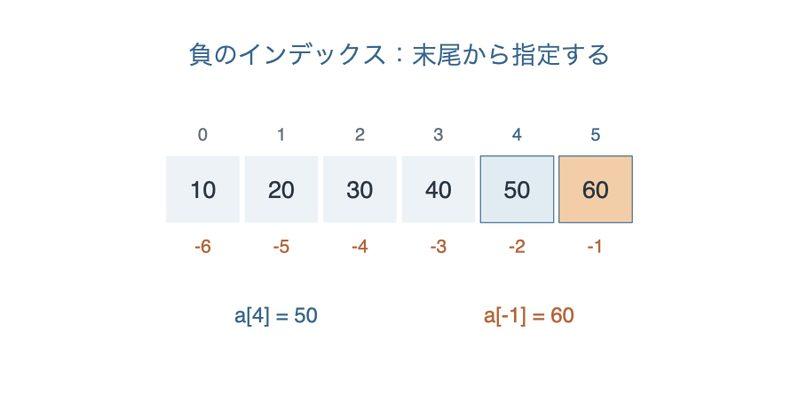
インデックスには、負の値を指定することもできます。
-1は最後の要素、-2は後ろから2番目の要素を表します。
print(a[-1])
print(a[-2])

# 実行結果:
# 60
# 50配列の最後の値を取り出したい場合は、a[-1]と書くと便利です。ただし、要素が1つもない空の配列には使用できません。
スライス:範囲を指定して取り出す
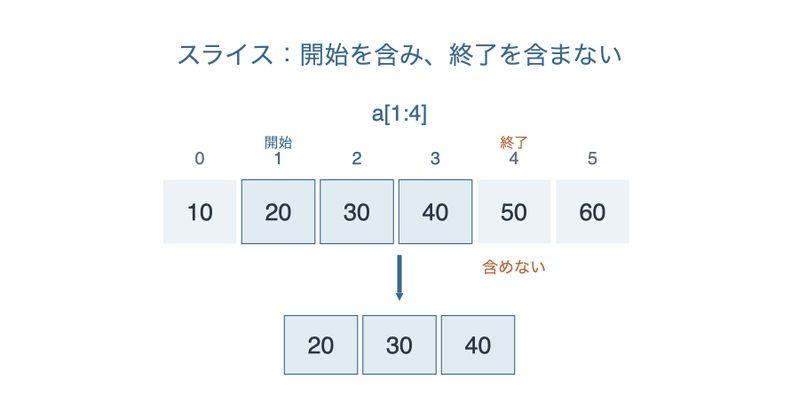
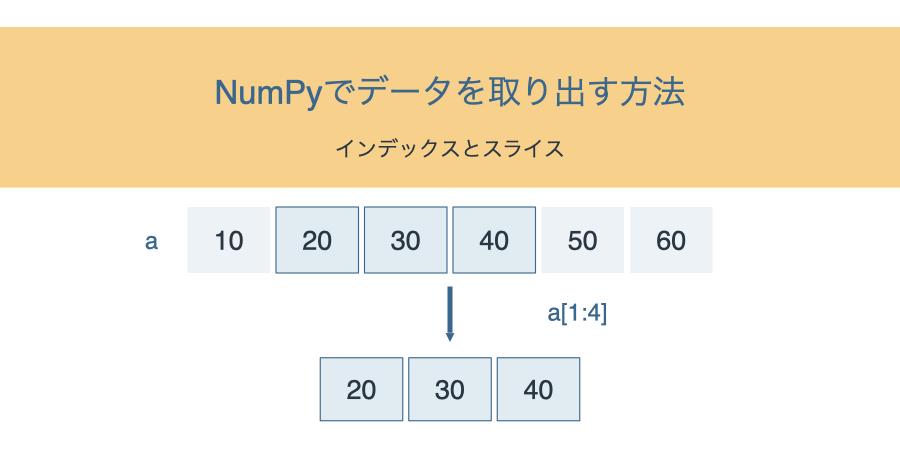
スライスは、配列から指定した範囲の要素をまとめて取り出すための書き方です。
基本的な書き方は次のとおりです。
配列[開始:終了]開始と終了には、要素の値ではなくインデックスを指定します。
例えば、インデックス1から3までの要素を取り出してみましょう。
print(a[1:4])

# 実行結果:
# [20 30 40]ここで注意したいのは、開始位置は含まれますが、終了位置は含まれないという点です。
今回の例では、終了位置を4と指定することで、その手前にあるインデックス3までが選ばれています。そのため、取り出される値は20、30、40となります。
開始位置や終了位置を省略する
通常のスライスでは、開始位置を省略すると先頭から、終了位置を省略すると末尾まで取り出せます。
print(a[:3])
print(a[3:])
print(a[:])

# 実行結果:
# [10 20 30]
# [40 50 60]
# [10 20 30 40 50 60]
それぞれの指定は、次のような意味になります。
| 書き方 | 取り出す範囲 |
|---|---|
a[:3] | 先頭からインデックス3の手前まで |
a[3:] | インデックス3から末尾まで |
a[:] | すべての要素 |
また、負のインデックスを使って範囲を指定することもできます。
print(a[-3:])

# 実行結果:
# [40 50 60]
この例では、後ろから3番目の位置から末尾までの要素が取り出されています。
間隔を指定して取り出す
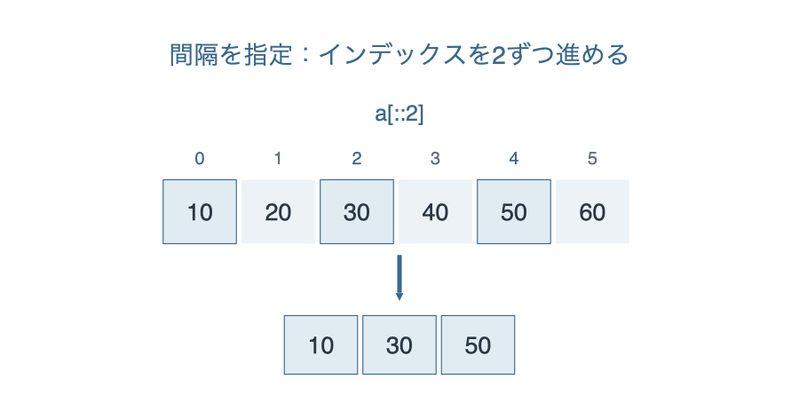
スライスでは、取り出す範囲だけでなく、間隔も指定できます。
配列[開始:終了:間隔]間隔を省略した場合は1となり、要素を順番に取り出します。例えば、間隔を2と指定すると、1つおきに取り出せます。
print(a[::2])
print(a[1::2])

# 実行結果:
# [10 30 50]
# [20 40 60]a[::2]ではインデックス0、2、4、a[1::2]ではインデックス1、3、5が選ばれています。
なお、間隔の2は、要素の値を2ずつ増やすという意味ではありません。インデックスを2ずつ進めることを表しています。
逆順に取り出す
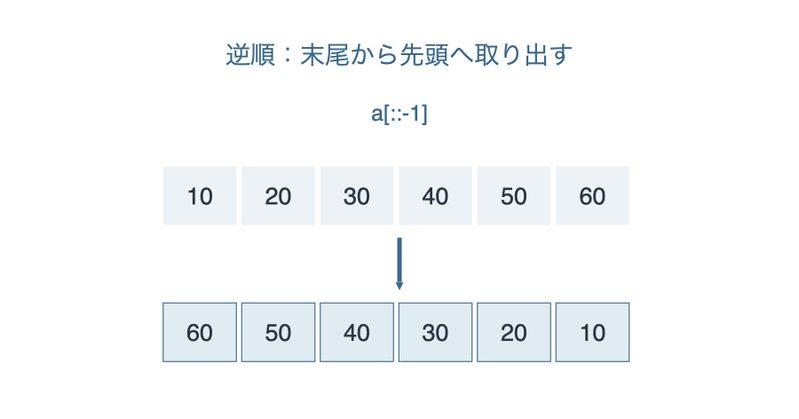
間隔に負の値を指定すると、後ろから前に向かって取り出せます。
例えば、配列全体を逆順に取り出す場合は、次のように記述します。
print(a[::-1])

# 実行結果:
# [60 50 40 30 20 10]間隔が-1で、開始と終了を省略しているため、末尾から先頭まで1つずつ取り出しています。
このように、間隔を負にした場合は、省略した開始・終了も逆向きに取り出すための設定になります。また、この操作だけで元の配列aの並び順が変更されるわけではありません。
2次元配列:行と列を指定して取り出す
次に、行と列を持つ2次元配列からデータを取り出してみましょう。
ここからは、次の3行4列の配列を使用します。
b = np.array([
    [10, 20, 30, 40],
    [50, 60, 70, 80],
    [90, 100, 110, 120]
])

print(b)

# 実行結果:
# [[ 10  20  30  40]
#  [ 50  60  70  80]
# [ 90 100 110 120]]行のインデックスは上から0、1、2、列のインデックスは左から0、1、2、3です。
1つの値を取り出す
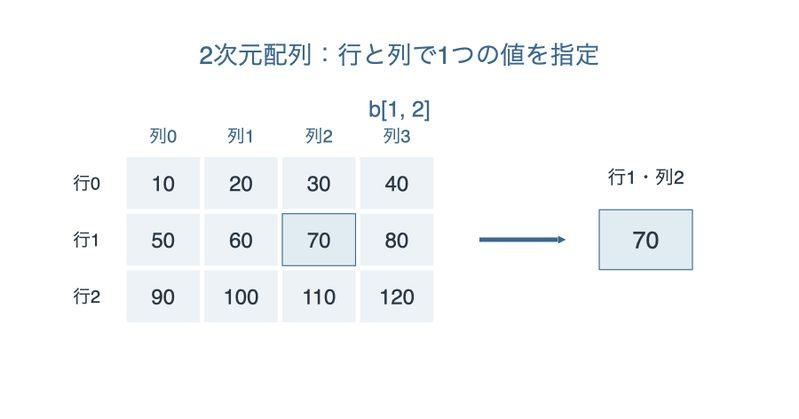
2次元配列から1つの値を取り出す場合は、行と列のインデックスをカンマで区切って指定します。
配列[行のインデックス, 列のインデックス]例えば、2行目・3列目の値を取り出してみましょう。
print(b[1, 2])

# 実行結果:
# 70行のインデックス1と列のインデックス2が交わる位置にある70が取り出されています。
**指定する順番は「行、列」**です。行と列は、どちらも0から数える点に注意してください。
また、2次元配列でも負のインデックスを使用できます。
print(b[-1, -1])

# 実行結果:
# 120この例では、最後の行・最後の列にある120が取り出されています。
行を取り出す
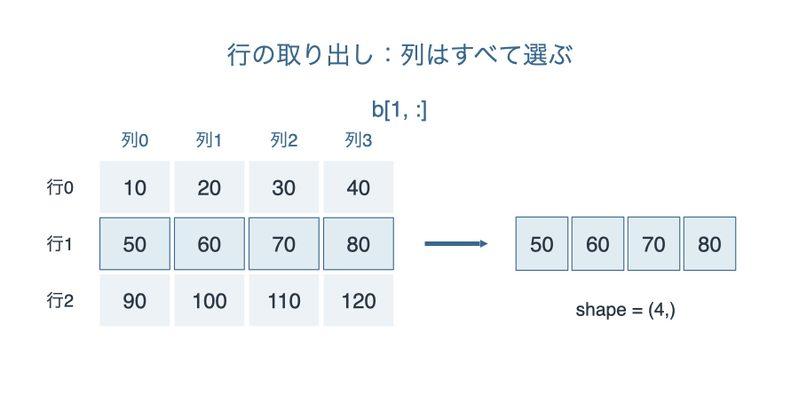
特定の行をまとめて取り出す場合は、列の位置に:を指定します。
:だけを指定すると、その方向のすべての要素を選ぶという意味になります。
print(b[1, :])

# 実行結果:
# [50 60 70 80]
b[1, :]では、行にインデックス1、列にすべてを指定しているため、2行目の値が取り出されています。
なお、この場合はb[1]と記述しても同じ結果が得られます。
列を取り出す
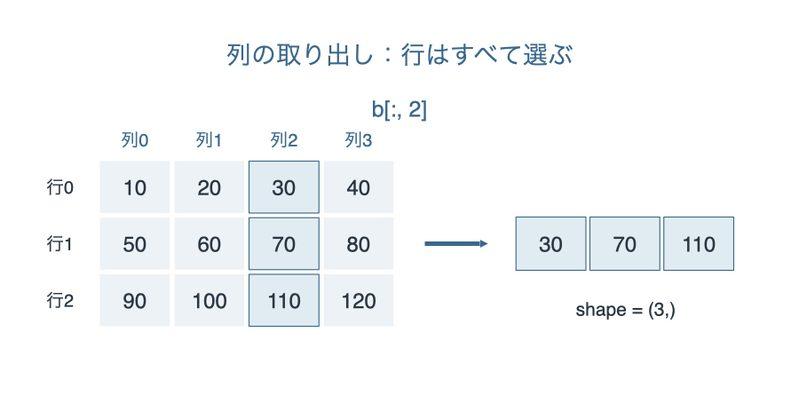
特定の列をまとめて取り出す場合は、行の位置に:を指定します。
print(b[:, 2])

# 実行結果:
# [ 30  70 110]
b[:, 2]では、行にすべて、列にインデックス2を指定しているため、3列目の値が取り出されています。
列を選んでいますが、取り出した結果は1次元配列となるため、print()では横一列に表示されます。列の形を残したい場合の書き方は、後ほど説明します。
行と列の範囲を指定して取り出す
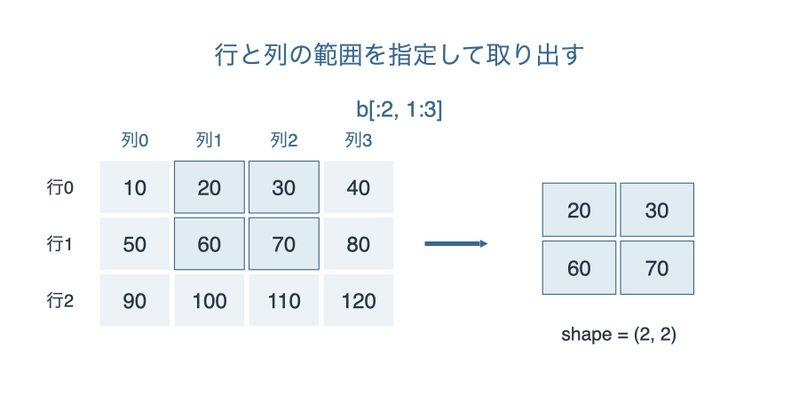
行と列の両方にスライスを指定することで、配列の一部分を取り出せます。
例えば、最初の2行から、2列目と3列目の値を取り出してみましょう。
print(b[:2, 1:3])

# 実行結果:
# [[20 30]
# [60 70]]行の:2ではインデックス0と1、列の1:3ではインデックス1と2を指定しています。
そのため、両方の範囲が重なる2行2列の部分が取り出されます。2次元配列でも、スライスの終了位置は含まれません。
整数とスライスで指定した場合の違い
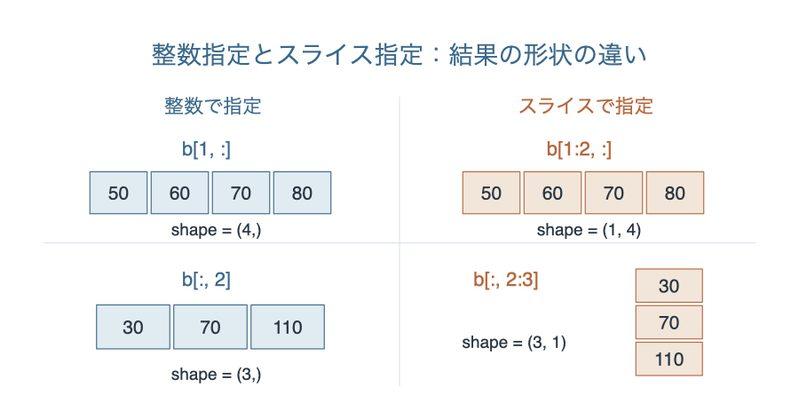
ここまで、整数のインデックスやスライスを使ってデータを取り出してきました。
この2つは、同じ値を取り出していても、結果の形状が異なる場合があります。
例えば、2行目を取り出す次の2つの書き方を比較してみましょう。
print(b[1, :])
print(b[1, :].shape)

print(b[1:2, :])
print(b[1:2, :].shape)

# 実行結果:
# [50 60 70 80]
# (4,)
# [[50 60 70 80]]
# (1, 4)shapeは、配列の形状を表す属性です。
b[1, :]では、行を整数で指定しているため、結果は要素数4の1次元配列となり、形状は(4,)です。
一方、b[1:2, :]では、行をスライスで指定しているため、1行4列の2次元配列となり、形状は(1, 4)になります。
このように、整数で指定すると、その方向の次元が減り、スライスで指定すると次元を残せます。
列を取り出す場合も、同じ考え方です。
print(b[:, 2])
print(b[:, 2].shape)

print(b[:, 2:3])
print(b[:, 2:3].shape)

# 実行結果:
# [ 30  70 110]
# (3,)
# [[ 30]
#  [ 70]
#  [110]]
# (3, 1)
それぞれの違いをまとめると、次のようになります。
| 書き方 | 結果の形状 | 次元数 |
|---|---|---|
b[1, :] | (4,) | 1次元 |
b[1:2, :] | (1, 4) | 2次元 |
b[:, 2] | (3,) | 1次元 |
b[:, 2:3] | (3, 1) | 2次元 |
なお、(4,)や(3,)の末尾のカンマは、値を1つ持つタプルを表すためのものです。
1行や1列の2次元配列として扱いたい場合は、スライスを使うとよいでしょう。
データを取り出す際の注意点
存在しないインデックスは指定できない
今回使用した配列aは要素数が6なので、先頭から指定できるインデックスは0から5です。
a[6]のように存在しない位置を指定すると、IndexErrorになります。
print(a[6])

# 実行結果(エラー):
# IndexError: index 6 is out of bounds for axis 0 with size 6
一方、スライスでは、終了位置が配列の長さを超えていても、存在する範囲までが選ばれます。
print(a[4:10])

# 実行結果:
# [50 60]
整数で1つの位置を指定する場合と、スライスで範囲を指定する場合では、このような違いがあります。
開始位置・終了位置と間隔の向きをそろえる
間隔を省略した場合は、インデックスが大きくなる方向に取り出します。
そのため、開始位置を4、終了位置を1と指定すると、取り出せる要素がなく、空の配列になります。
print(a[4:1])
print(a[4:1:-1])

# 実行結果:
# []
# [50 40 30]
後ろから取り出したい場合は、間隔を負にする必要があります。
a[4:1:-1]では、インデックス4、3、2の順に取り出されます。逆向きの場合も終了位置の1は含まれません。また、間隔に0を指定することはできません。
スライスで取り出した配列は元のデータを共有する
NumPyでは、スライスで取り出した配列は、元の配列とデータを共有する「ビュー」になります。
そのため、取り出した配列の要素を書き換えると、元の配列にも変更が反映されます。
元の配列に影響を与えずに変更したい場合は、copy()を使って独立したコピーを作成します。
part = a[1:4].copy()
print(part)

# 実行結果:
# [20 30 40]
コピーとビューの詳しい違いは、次回の記事で解説します。
NumPyを基礎から学びたい方へ
今回は、インデックスとスライスを使って、NumPyの配列からデータを取り出す方法を紹介しました。
NumPyをデータ分析や機械学習で活用するためには、今回の取り出し操作に加えて、配列を使った計算や集計、形状の変更なども理解しておくと役立ちます。
そこで、NumPyの基本操作を体系的に学びたい方向けに、Kindle書籍『機械学習・データ分析のためのNumPy入門 ― 配列操作と数値計算の基本をPythonで学ぶ ―』を執筆しました。
本書では、配列の作成やインデックス・スライス、条件抽出、集計、ブロードキャストなどを、コード例と演習問題を通じて学べる構成にしています。
「説明を読むだけでなく、自分でコードを書いて理解を深めたい」「データ分析や機械学習に向けてNumPyの基本を身につけたい」という方は、ぜひチェックしてみてください!
まとめ
今回は、NumPyの配列からデータを取り出す方法について解説しました。
今回紹介した書き方をまとめると、次のようになります。
| 書き方 | 用途 |
|---|---|
a[0] | 先頭の要素を取り出す |
a[-1] | 最後の要素を取り出す |
a[1:4] | インデックス1から3までを取り出す |
a[::2] | 1つおきに取り出す |
a[::-1] | 全体を逆順に取り出す |
b[1, 2] | 2行目・3列目の値を取り出す |
b[1, :] | 2行目を取り出す |
b[:, 2] | 3列目を取り出す |
b[:2, 1:3] | 行と列の範囲を指定して取り出す |
b[1:2, :] | 1行4列の形を残して取り出す |
b[:, 2:3] | 3行1列の形を残して取り出す |
インデックスは0から始まり、スライスの終了位置は含まれません。また、2次元配列では「行、列」の順に指定することがポイントです。
取り出した配列をその後の処理に使う場合は、値だけでなくshapeも確認しておきましょう。
まずは今回紹介したコードを実際に動かして、インデックスや範囲を変えると、どの値が取り出されるのかを確認してみてください!