こんにちは、ぼりたそです!
今回は、NumPyを使ったデータの前処理として、欠損値の扱いと標準化について解説します。
実際のデータには、測定できなかった値が含まれていたり、項目ごとに数値のスケールが大きく異なっていたりします。こうしたデータをそのまま計算に使う前に、目的に応じて整えることが大切です。
np.isnan():NaNの位置を調べるnp.nanmean():NaNを除外して平均を求める- 欠損値を含む行の除外と、平均値による補完
- 平均・標準偏差を使った列ごとの標準化
- 標準偏差0の列と、学習・評価データを扱う際の注意点
それでは順番に確認していきましょう!
前処理とは?
前処理は、分析や機械学習に使いやすい形へデータを整える作業です。ここでは、欠損値への対応と、数値のスケールをそろえる標準化を扱います。
最初にNumPyを読み込みます。以降のコードは、この読み込みを実行した状態を前提とします。
import numpy as np今回は、数値とnp.nanを含む浮動小数点数の配列を使用します。2次元配列では、行をサンプル、列を測定項目や特徴量として考えます。無限大のinfは含まない前提です。
NaNとは?欠損値を表す値
NaNは「Not a Number」の略で、通常の数値として表せないことを示す値です。NumPyではnp.nanと書き、欠損値を表すためにも使います。
ただし、計算の結果としてNaNが発生する場合もあります。元から欠損していたのか、計算の途中で生じたのかも確認しましょう。
a = np.array([10.0, np.nan, 30.0])

print(a)
print(np.mean(a))

# 実行結果:
# [10. nan 30.]
# nan通常のnp.mean()では、対象にNaNが含まれると平均もnanになります。欠損値があっても、自動的に除外して計算するわけではありません。
np.isnan():NaNの位置を調べる
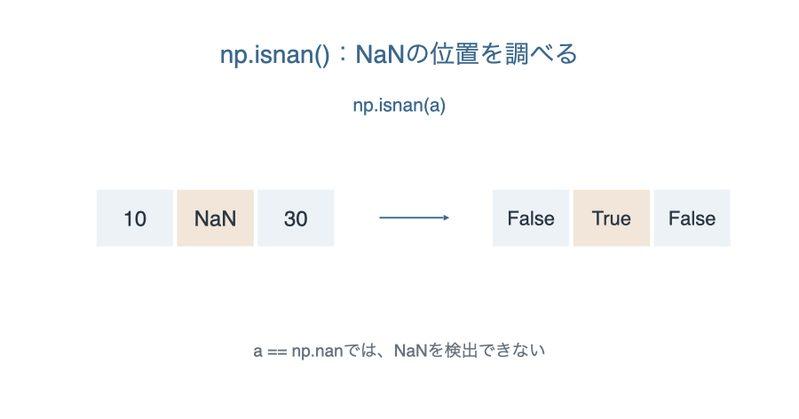
np.isnan()は、各要素がNaNかどうかを判定する関数です。
a = np.array([10.0, np.nan, 30.0])

print(np.isnan(a))
print(a == np.nan)

# 実行結果:
# [False  True False]
# [False False False]np.isnan(a)では、NaNの位置がTrueになります。一方、a == np.nanではNaNを正しく検出できません。NaNの判定には、等号比較ではなくnp.isnan()を使います。
NaN以外の値を取り出す場合は、真偽値を反転する~と組み合わせます。
print(a[~np.isnan(a)])

# 実行結果:
# [10. 30.]ここでの~は、TrueとFalseを反転する働きです。
np.nanmean():NaNを除外して平均を求める
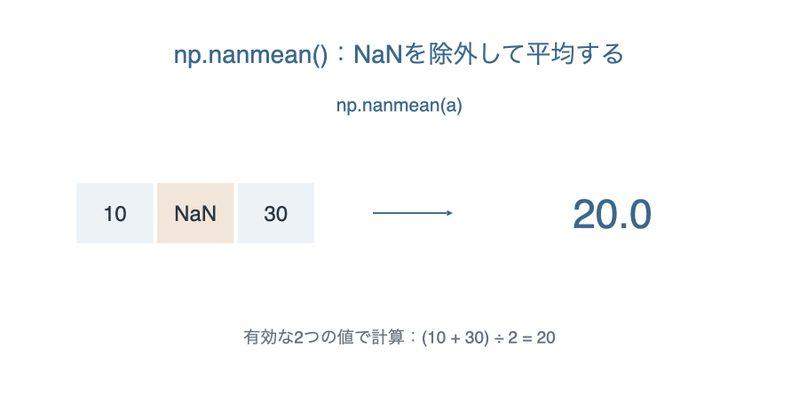
NaNを計算対象から除いて平均を求めるには、np.nanmean()を使います。
a = np.array([10.0, np.nan, 30.0])

print(np.nanmean(a))
print(np.mean(np.where(np.isnan(a), 0, a)))

# 実行結果:
# 20.0
# 13.333333333333334np.nanmean(a)は、有効な2つの値で(10 + 30) / 2 = 20を計算します。
NaNを0に置き換えた後の平均は、(10 + 0 + 30) / 3です。欠損値を除外することと、0として扱うことは異なります。
また、np.nanmean()は平均を返すだけで、元の配列のNaNを埋めるわけではありません。標準偏差にはnp.nanstd()、合計にはnp.nansum()というNaNを除外する関数もあります。
欠損値を含む行を除外する
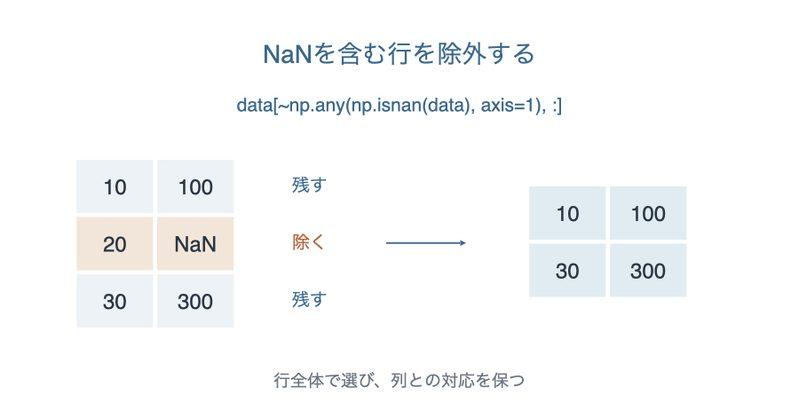
2次元配列では、欠損した要素だけを抜き出すと、サンプルと列の対応が崩れることがあります。行全体を残すかどうかで選びたい場合は、行ごとのマスクを作ります。
data = np.array([
    [10.0, 100.0],
    [20.0, np.nan],
    [30.0, 300.0]
])

missing_row = np.any(np.isnan(data), axis=1)
clean = data[~missing_row, :]

print(missing_row)
print(clean)

# 実行結果:
# [False  True False]
# [[ 10. 100.]
# [ 30. 300.]]np.any()は、対象にTrueが1つでもあるかを調べます。axis=1を指定しているため、各行にNaNがあるかを判定します。
その結果を~で反転し、NaNがない行を残しています。今回の例では、2行目を除いた2行2列の配列になります。
除外するとデータ数が減ります。欠損が多い場合や、特定のサンプルに欠損が偏っている場合は、分析結果への影響にも注意が必要です。
欠損値を列ごとの平均で補完する
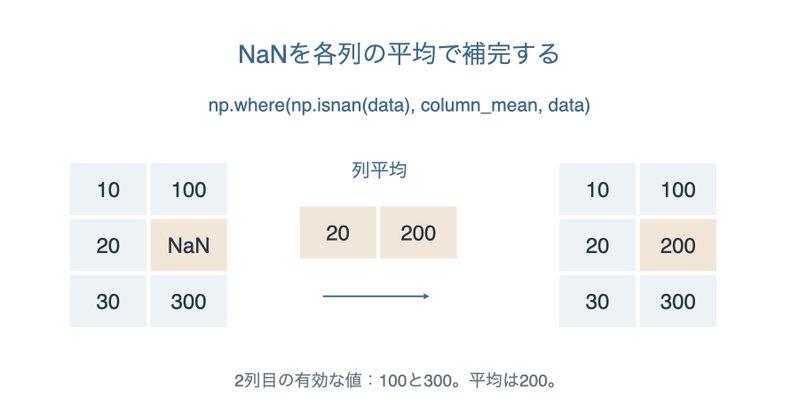
行を残したい場合は、欠損値を別の値で埋める「補完」を検討できます。ここでは、同じ列の有効な値から求めた平均を使います。
data = np.array([
    [10.0, 100.0],
    [20.0, np.nan],
    [30.0, 300.0]
])

column_mean = np.nanmean(data, axis=0)
filled = np.where(np.isnan(data), column_mean, data)

print(column_mean)
print(filled)

# 実行結果:
# [ 20. 200.]
# [[ 10. 100.]
#  [ 20. 200.]
# [ 30. 300.]]1列目の平均は20、2列目はNaNを除いた(100 + 300) / 2 = 200です。np.where()により、NaNの位置だけを対応する列の平均で置き換えています。
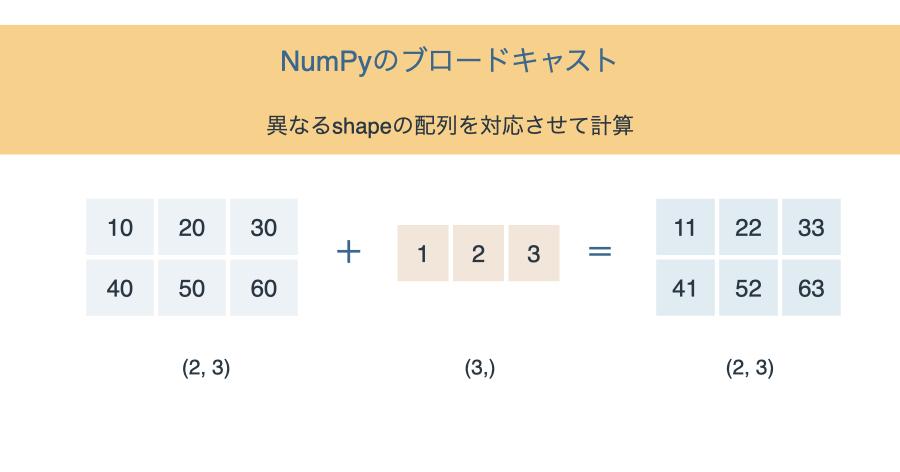
条件の形状は(3, 2)、列平均の形状は(2,)です。ブロードキャストによって、各列の平均がすべての行に対応します。元の配列dataは変更されません。
除外・集計・補完の違い
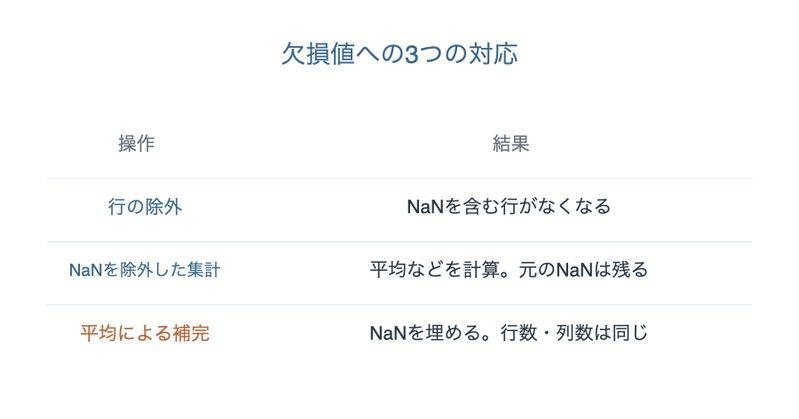
| 方法 | 結果 | 考え方 |
|---|---|---|
| 欠損値を含む行の除外 | 残した行だけの配列 | データ数が減る |
np.nanmean()による集計 | 有効な値の平均 | 元データの欠損は残る |
| 平均値による補完 | 欠損位置を埋めた配列 | 元の行数・列数を保つ |
平均補完は簡単ですが、欠損していた本当の値を復元する処理ではありません。平均付近に値が増えるため、ばらつきや変数間の関係も変わります。データの意味や欠損の理由に応じて使い分けましょう。
標準化:平均0・標準偏差1にそろえる
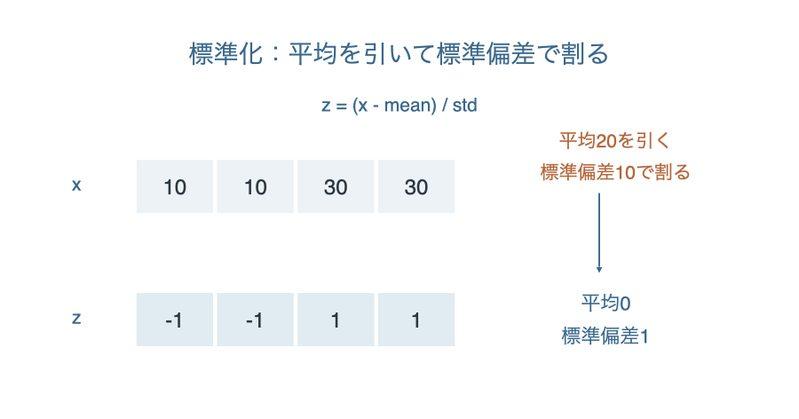
ここで扱う標準化は、各値から平均を引き、標準偏差で割る方法です。
標準化した値 = (元の値 - 平均) / 標準偏差計算に使ったデータについて、標準偏差が0でなければ、平均はおよそ0、標準偏差はおよそ1になります。
x = np.array([10.0, 10.0, 30.0, 30.0])
mean = np.mean(x)
std = np.std(x)
z = (x - mean) / std

print(mean)
print(std)
print(z)
print(np.mean(z))
print(np.std(z))

# 実行結果:
# 20.0
# 10.0
# [-1. -1.  1.  1.]
# 0.0
# 1.0
平均20を引いて標準偏差10で割ると、10は-1、30は1になります。
ここではnp.std()の標準設定であるddof=0を使用します。標準化は値の中心とスケールを変える処理であり、分布を正規分布に変える処理ではありません。また、0〜1の範囲に収める処理とも異なります。
2次元配列を列ごとに標準化する
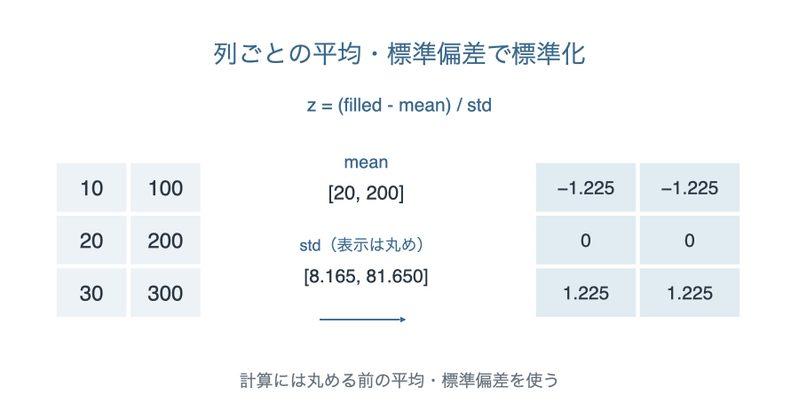
行をサンプル、列を特徴量として扱う場合は、通常、列ごとに平均と標準偏差を求めます。
先ほど補完した配列を、列ごとに標準化してみましょう。
data = np.array([
    [10.0, 100.0],
    [20.0, np.nan],
    [30.0, 300.0]
])

column_mean = np.nanmean(data, axis=0)
filled = np.where(np.isnan(data), column_mean, data)
mean = np.mean(filled, axis=0)
std = np.std(filled, axis=0)
z = (filled - mean) / std

print(np.round(mean, 3))
print(np.round(std, 3))
print(np.round(z, 3))
print(np.allclose(np.mean(z, axis=0), 0))
print(np.allclose(np.std(z, axis=0), 1))

# 実行結果:
# [ 20. 200.]
# [ 8.165 81.65 ]
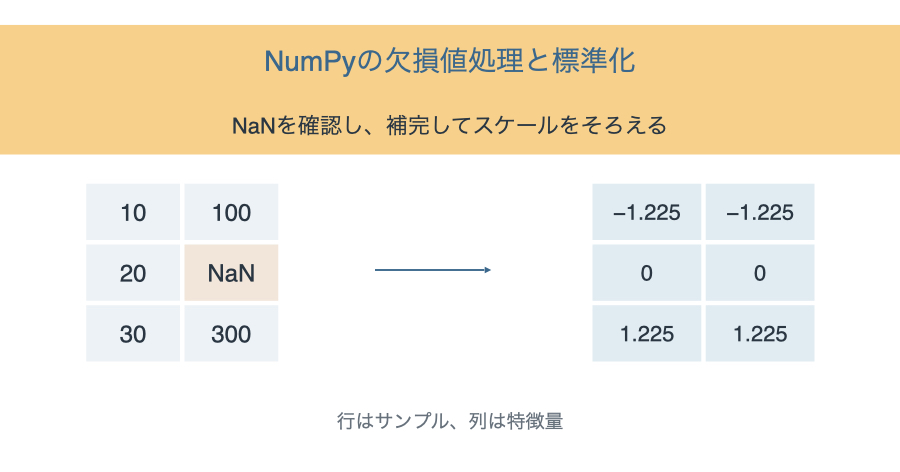
# [[-1.225 -1.225]
#  [ 0.     0.   ]
#  [ 1.225  1.225]]
# True
# True
1列目の平均20・標準偏差約8.165、2列目の平均200・標準偏差約81.650を使います。各列で平均との差を、その列の標準偏差で割っています。
np.round(値, 3)は表示用に小数点以下3桁へ丸める関数です。標準化の計算自体には、丸める前の値を使っています。
np.allclose()は、丸め誤差を考慮して数値が近いかを判定します。最後の2つのTrueは、列ごとの平均が0、標準偏差が1に十分近いことを示します。
補完でデータのばらつきが変わるため、この例では補完後のデータから標準偏差を計算しています。
前処理・標準化の注意点
すべてNaNの列は、平均で補完できない
ある列がすべてNaNなら、平均を求める有効な値がありません。np.nanmean()はその列についてnanを返し、標準設定では警告も表示します。
そのまま平均補完をしてもNaNが残るため、列を除く、別の根拠に基づく値を使う、データを再確認するなど、方針を決める必要があります。
標準偏差が0の列では、そのまま割らない
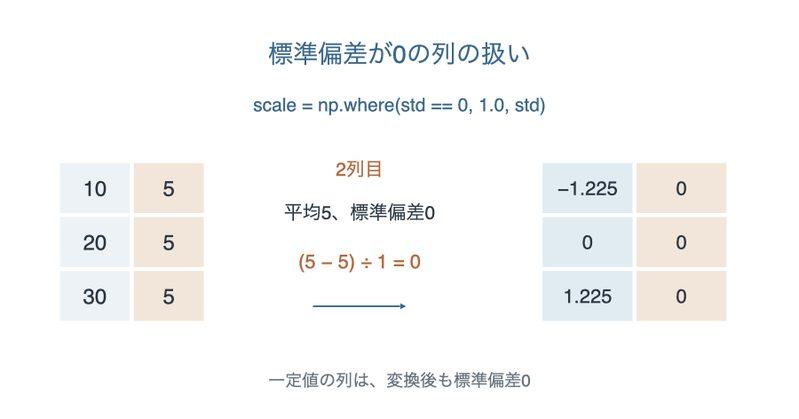
すべて同じ値の列は標準偏差が0です。そのまま割ると、有限の標準化結果を得られません。
次は、標準偏差0の列の割る値を1に置き換える例です。
data = np.array([
    [10.0, 5.0],
    [20.0, 5.0],
    [30.0, 5.0]
])

mean = np.mean(data, axis=0)
std = np.std(data, axis=0)
scale = np.where(std == 0, 1.0, std)
z = (data - mean) / scale

print(np.round(std, 3))
print(np.round(z, 3))

# 実行結果:
# [8.165 0.   ]
# [[-1.225  0.   ]
#  [ 0.     0.   ]
# [ 1.225 0. ]]2列目は平均5を引くとすべて0になります。その0を1で割るため、結果は0のままです。この列の標準偏差は1にはならず、0のままです。
一定値の列を分析に残すか、除くかは目的に応じて判断します。この例は標準偏差が厳密に0の場合を扱っており、極端に小さい標準偏差まで一律に処理するものではありません。
学習データと評価データで基準を共有する
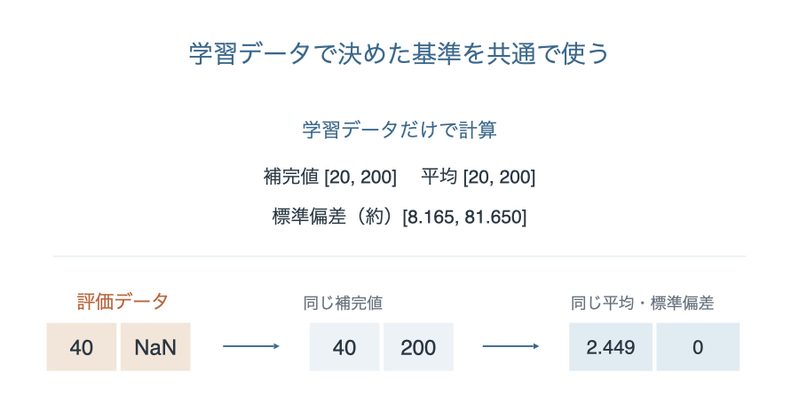
機械学習では、最初に学習用と評価用のデータを分けます。補完値・平均・標準偏差は学習データだけから求め、評価データや新しいデータには同じ値を使います。
train = np.array([
    [10.0, 100.0],
    [20.0, np.nan],
    [30.0, 300.0]
])
test = np.array([[40.0, np.nan]])

fill_value = np.nanmean(train, axis=0)
train_filled = np.where(np.isnan(train), fill_value, train)
test_filled = np.where(np.isnan(test), fill_value, test)

mean = np.mean(train_filled, axis=0)
std = np.std(train_filled, axis=0)
scale = np.where(std == 0, 1.0, std)

train_z = (train_filled - mean) / scale
test_z = (test_filled - mean) / scale

print(test_filled)
print(np.round(test_z, 3))

# 実行結果:
# [[ 40. 200.]]
# [[2.449 0.   ]]
評価データのNaNには、学習データで求めた200を使っています。標準化にも、学習データの平均と標準偏差を使います。
評価データ自身の平均・標準偏差を使うと、学習時と異なる基準になります。また、分割前の全データで基準を決めると、評価用の情報が学習側に入り込む「データリーク」につながります。交差検証でも、各分割の学習側だけで基準を求めます。
評価データの変換後の平均が0、標準偏差が1になる必要はありません。このコードは、学習データの各列に少なくとも1つ有効な値がある前提です。
NumPyを基礎から学びたい方へ
今回の前処理には、条件抽出、集計、配列の一括計算、ブロードキャストが登場しました。基本操作を組み合わせることで、実際のデータを扱うための処理を書けます。
こうした基礎を順番に学びたい方向けに、Kindle書籍『機械学習・データ分析のためのNumPy入門 ― 配列操作と数値計算の基本をPythonで学ぶ ―』を執筆しました。
本書では、配列の作成やデータの取り出し、条件抽出、集計、ブロードキャストなどを、コード例と演習問題を通じて学べます。
「コードを読むだけでなく、自分で書いて理解を深めたい」という方は、ぜひチェックしてみてください!
まとめ
今回は、NumPyを使った欠損値の処理と標準化について解説しました。
| 書き方 | 用途・特徴 |
|---|---|
np.isnan(a) | NaNの位置を調べる |
np.nanmean(a) | NaNを除外して平均を求める |
np.any(np.isnan(data), axis=1) | NaNを含む行を調べる |
np.where(np.isnan(data), column_mean, data) | 列平均で補完する |
(data - mean) / std | 平均・標準偏差を使って標準化する |
np.where(std == 0, 1.0, std) | 標準偏差0の列で割る値を1にする |
欠損値の除外・補完・集計は、それぞれ結果が異なります。また、標準化では、列ごとに基準を求めることと、標準偏差0の列に注意することがポイントです。
まずは欠損する位置や値を変えて、補完値と標準化結果がどう変化するかを確認してみてください!