こんにちは!ぼりたそです!
今回は、pandasのDataFrame(データフレーム)の作成方法と、データを確認するための基本操作を解説します。
CSVやExcelのデータを分析するときは、いきなり加工や集計を始めるのではなく、まず「どのような列があるか」「データは何行あるか」「数値として扱えるか」を確かめることが大切です。
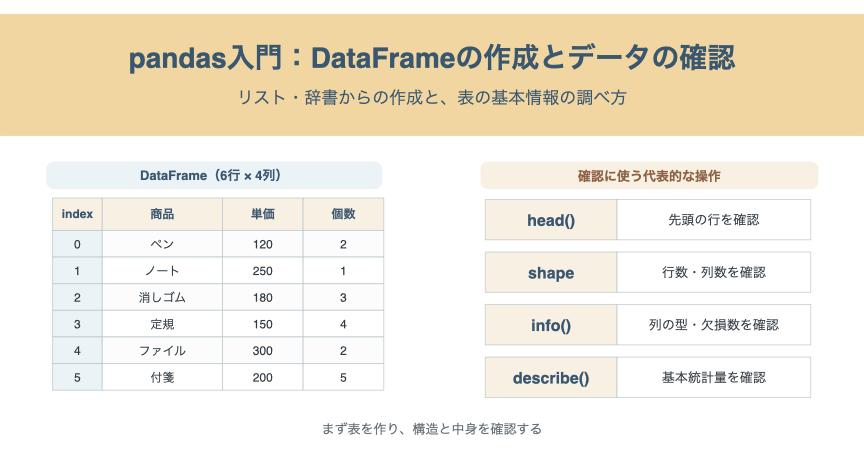
この記事では、身近な商品の販売データを使って、リスト・辞書からのDataFrame作成から、head()・shape・info()・describe()などの使い方まで、コードと実行結果を交えて紹介します。
この記事で学べること
- Pythonのリスト・辞書からDataFrameを作る方法
head()・tail()で先頭・末尾の行を表示する方法shape・columns・indexで表の構造を調べる方法dtypes・info()・describe()でデータの特徴を確認する方法
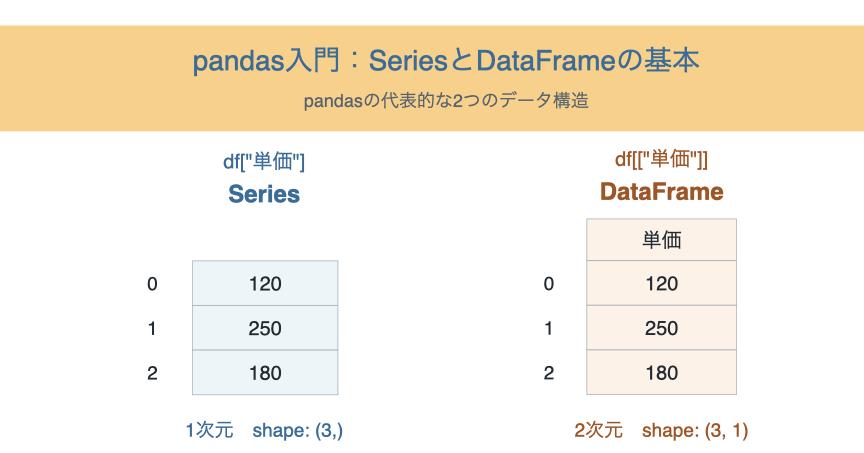
DataFrameの基本的な構造から復習したい場合は、以下の記事をご参照ください。

DataFrameを作成する方法
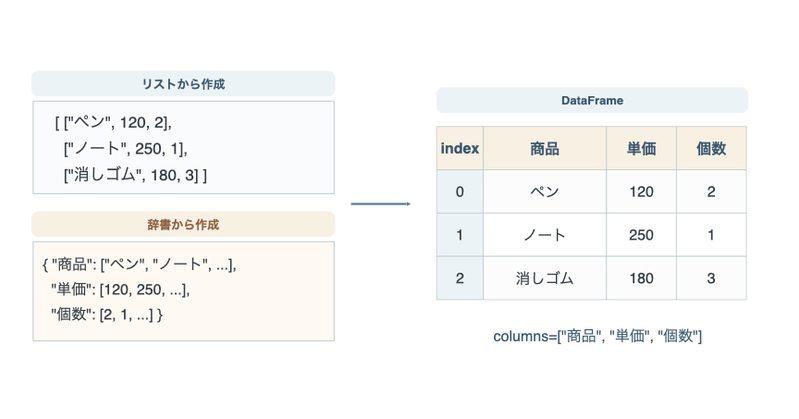
DataFrameは、行と列で構成される2次元の表形式データです。pd.DataFrame()を使うと、Pythonのリストや辞書から作成できます。
まず、pandasを読み込みます。
import pandas as pdas pdはpandasに短い別名を付ける記述です。以降はpd.DataFrame()という形で使用します。
リストからDataFrameを作成する
リストを使う場合は、内側のリストが1行分のデータに対応します。
rows = [
    ["ペン", 120, 2],
    ["ノート", 250, 1],
    ["消しゴム", 180, 3]
]

df_list = pd.DataFrame(rows, columns=["商品", "単価", "個数"])
print(df_list)

# 実行結果:
#      商品   単価  個数
# 0    ペン  120   2
# 1   ノート  250   1
# 2 消しゴム 180 3columns=で列名を指定しています。columnsを省略すると、列名には通常0・1・2が使われます。左端の0・1・2は行のラベルであるインデックスで、データ列とは別です。
リストから作るときは、各行に入れる値の順番と、columnsで指定した列名の順番を一致させましょう。
辞書からDataFrameを作成する
辞書を使う場合は、辞書のキーが列名、キーに対応するリストが列の値になります。
df = pd.DataFrame({
    "商品": ["ペン", "ノート", "消しゴム", "定規", "ファイル", "付箋"],
    "単価": [120, 250, 180, 150, 300, 200],
    "個数": [2, 1, 3, 4, 2, 5],
    "店舗": ["東京", "大阪", "東京", "大阪", "東京", "大阪"]
})

print(df)

# 実行結果:
#      商品   単価  個数  店舗
# 0    ペン  120   2  東京
# 1   ノート  250   1  大阪
# 2  消しゴム  180   3  東京
# 3    定規  150   4  大阪
# 4  ファイル  300   2  東京
# 5 付箋 200 5 大阪この例では、6行4列のDataFrameが作成されます。辞書から作成するときは、通常、各列のリストの要素数をそろえる必要がある点に注意してください。例えば「商品」が6個なのに「単価」が5個しかないと、エラーになります。
どちらの方法でも同じような表を作成できますが、行ごとに値が並んでいるならリスト、項目ごとに値が整理されているなら辞書を使うと考えるとわかりやすいでしょう。
head()・tail()で先頭と末尾の行を確認する
実際のデータは何百行、何万行にもなることがあります。すべて表示する前に、先頭や末尾の数行を確認すると、列の並びやデータの内容をすばやく把握できます。
head()は先頭から、tail()は末尾から指定した行数を返します。
print(df.head(3))
print(df.tail(2))

# head(3)の実行結果:
#      商品   単価  個数  店舗
# 0    ペン  120   2  東京
# 1   ノート  250   1  大阪
# 2  消しゴム  180   3  東京
#
# tail(2)の実行結果:
#      商品   単価  個数  店舗
# 4  ファイル  300   2  東京
# 5 付箋 200 5 大阪head(3)は先頭3行、tail(2)は末尾2行です。引数を省略したhead()・tail()では、それぞれ5行が返されます。ただし、データが5行未満なら存在する行だけが表示されます。
これらの操作は元のDataFrameから一部を取り出して返すもので、元のdfから行が削除されるわけではありません。
shape・columns・indexで表の構造を確認する
データの中身を見たら、次に行数・列数・列名・インデックスを確認しましょう。
print(df.shape)
print(df.columns.tolist())
print(df.index.tolist())

# 実行結果:
# (6, 4)
# ['商品', '単価', '個数', '店舗']
# [0, 1, 2, 3, 4, 5]
shapeは(行数, 列数)を表す
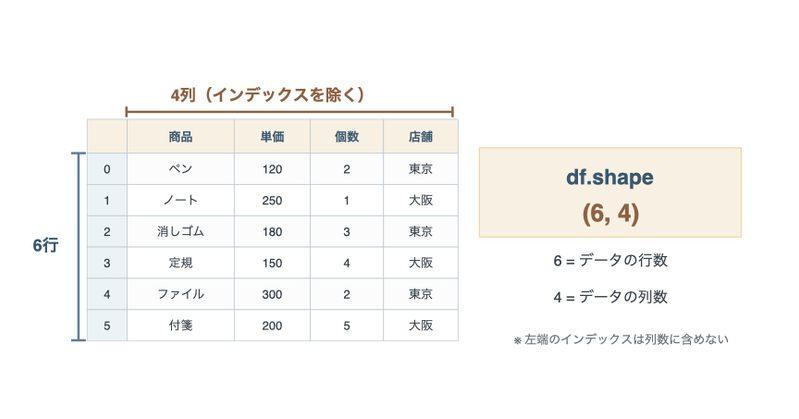
df.shapeは、DataFrameのサイズを**(行数, 列数)**の順番で返します。今回は6行4列なので(6, 4)です。左端のインデックスは、列数に含まれません。
行数だけを知りたい場合はdf.shape[0]、列数だけならdf.shape[1]で取り出せます。
columnsは列名、indexは行のラベル
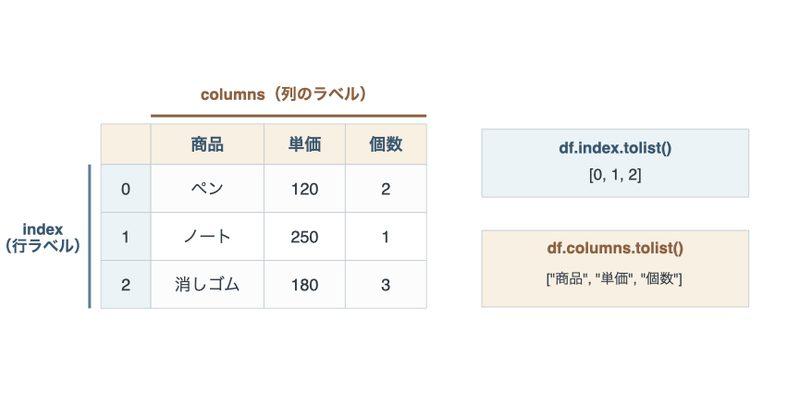
df.columnsは列名、df.indexは行のラベルを表します。上のコードでは、結果を見やすくするために.tolist()でリストに変換しました。
ここで間違えやすいのが、インデックスと行の位置番号は必ずしも同じではないという点です。行の削除や独自のラベルの設定によって、インデックスが0, 1, 2, ...にならない場合もあります。
なお、shape・columns・indexは属性なので、df.shape()のように末尾に()を付けません。一方、head()・tail()はメソッドなので()が必要です。
dtypes・info()でデータ型と表の概要を調べる
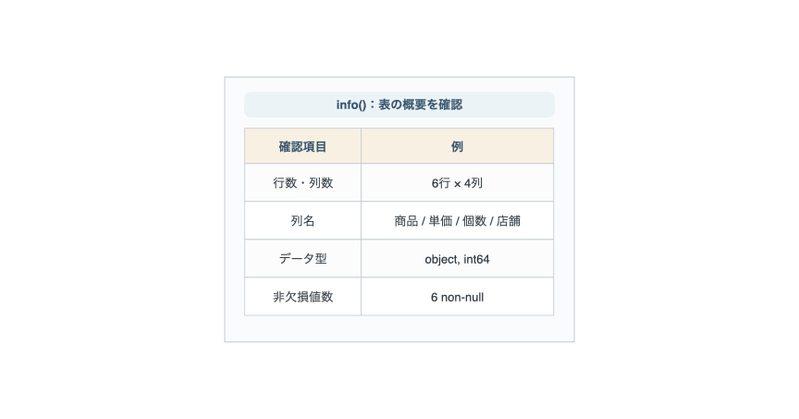
DataFrameでは、列ごとに異なるデータ型を持つことができます。数値として計算したい列が文字列として読み込まれていないかを調べるには、dtypesとinfo()が便利です。
print(df.dtypes)

# 実行結果の例(pandas 2.x):
# 商品    object
# 単価     int64
# 個数     int64
# 店舗    object
# dtype: objectint64は整数型、objectは文字列などのPythonオブジェクトを格納できる型です。pandasのバージョンや作成方法によっては、文字列の列がstrなどの型として表示される場合もあります。
さらに、info()を使うと列名・データ型・欠損していない値の数などをまとめて調べられます。
df.info()実行結果には、RangeIndex: 6 entries、Data columns (total 4 columns)のような情報が表示されます。各列のNon-Null Countが6 non-nullなら、6行すべてに欠損していない値が入っていることを意味します。
今回は欠損値のないデータを使っているため、どの列も6件です。例えば6行のうち1件が欠損している列なら、通常は5 non-nullとなります。欠損値の具体的な処理方法は、後の記事で解説します。
info()は実行時に情報を出力するメソッドなので、print(df.info())と書く必要はありません。そうすると、表の情報に続いてNoneも表示されます。
describe()で基本統計量を確認する
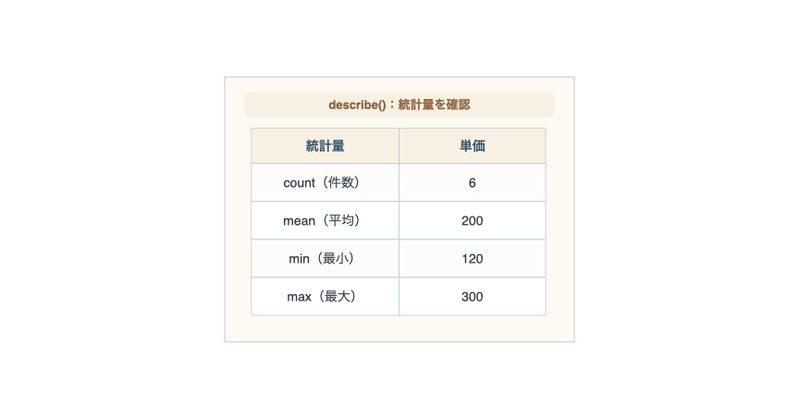
describe()は、数値列の件数・平均・標準偏差・最小値・四分位数・最大値をまとめて確認できるメソッドです。
print(df.describe().round(2))

# 実行結果:
#           単価    個数
# count    6.00  6.00
# mean   200.00  2.83
# std     66.03  1.47
# min    120.00  1.00
# 25%    157.50  2.00
# 50%    190.00  2.50
# 75%    237.50  3.75
# max 300.00 5.00.round(2)は見やすいように数値を小数第2位まで丸める操作です。meanは平均値、minとmaxは最小値・最大値、50%は中央値を表します。countは欠損値を除いたデータ数である点も覚えておきましょう。
今回、単価の平均は200円、最小値は120円、最大値は300円だと確認できます。
describe()は、数値列と文字列列が混在するDataFrameでは、通常は数値列を対象にします。文字列の列も含めて確認したい場合は、次のようにします。
print(df.describe(include="all"))文字列列には、異なる値の個数を表すuniqueや、最も多く現れる値を表すtopなどが表示されます。一方、その列に適用できない統計量はNaNになります。
DataFrameの確認でよくある間違い
初学者の方が特につまずきやすいポイントは、次の3つです。
df.shape()と書いてしまう:shapeは属性なので、正しくはdf.shapeです。dtypes・columns・indexも同様です。head()で表示されなかった行が消えたと思う:head()は先頭の行を確認するだけで、元のデータは残っています。describe()で文字列列が表示されない:数値列が含まれる場合、通常のdescribe()では数値列が対象です。列全体を確認したいときはinclude="all"を指定します。
実際のCSV・Excelデータを扱う場合も、まずhead()・shape・info()・describe()の順に確認すると、データの構造と特徴をつかみやすくなります。
pandas入門書の紹介
この記事では、DataFrameの作成方法と基本的な確認操作を紹介しました。実務やデータ分析では、この後にデータの抽出、欠損値の処理、列の追加、グループ化と集計などを組み合わせて使用します。
そこで、pandasを基礎から体系的に学びたい方向けに、Kindle書籍**『機械学習・データ分析のためのpandas入門 ― データ加工と集計の基本をPythonで学ぶ ―』**(著者:ぼりたそ)を執筆しました。
本書では、Series・DataFrameの基本から、CSV・Excelの入出力、条件抽出、データの加工・集計、表の結合・変形まで段階的に解説しています。解説に加えて演習も用意しているので、操作を自分の手で試しながら理解を深められます。
「必要な操作をブログで調べる」だけでなく、「データ処理の流れを順番に身に付けたい」という方におすすめです。
まとめ
今回は、DataFrameの作成方法とデータの確認方法を解説しました。
pd.DataFrame()を使うと、リストや辞書から表を作成できます。head()・tail()で先頭・末尾の行を確認できます。shapeは(行数, 列数)、columnsは列名、indexは行のラベルです。dtypes・info()で列のデータ型や欠損していない件数を確認できます。describe()で数値列の基本統計量をまとめて確認できます。
データを加工する前に、まずデータの構造と内容を確認することが大切です。
次回は、CSV・Excelファイルの読み込みと保存について解説します。