こんにちは!ぼりたそです!
今回は、Pythonで表形式のデータを扱うライブラリ「pandas(パンダス)」について解説します。
「pandasを使うと何ができるの?」「SeriesとDataFrameは何が違うの?」と疑問に感じている方も多いのではないでしょうか。
pandasを使うと、Excelの表のように行と列で整理されたデータを、Pythonで読み込み、加工、集計できます。CSV・Excelの処理だけでなく、データ分析や機械学習の前処理にも役立ちます。
この記事で学べること
- pandasの役割とNumPyとの違い
- SeriesとDataFrameの基本的な構造
- 行・列・インデックス(index)の意味
- Seriesと1列のDataFrameの違い
Pythonのリストや辞書を知っていれば読み進められます。NumPyの知識は必要ありません。それでは、順番に見ていきましょう!
pandasとは?
pandasは、表形式のデータの読み込み・加工・集計が得意なPythonライブラリです。
例えば、次のような商品ごとの販売データがあったとします。
| 商品 | 単価 | 個数 |
|---|---|---|
| ペン | 120 | 2 |
| ノート | 250 | 1 |
| 消しゴム | 180 | 3 |
pandasを使うと、この表をPython上で扱い、単価の列を取り出したり、「単価×個数」で金額を求めたりできます。行数が多いデータでも、手作業で表を編集する代わりに、同じ処理をコードで繰り返せます。
代表的な用途には、CSV・Excelファイルの読み込み、条件に合う行の抽出、欠損値の処理、店舗別・商品別の集計などがあります。
NumPyとの違い
NumPyもデータ分析によく使われますが、主に得意とする操作が異なります。
| ライブラリ | 主な得意分野 | 代表的なデータ構造 |
|---|---|---|
| NumPy | 多次元配列を使った数値計算 | ndarray |
| pandas | 行や列にラベルを持つ表の加工・集計 | Series、DataFrame |
NumPyは数値配列の計算を効率よく進めたいときに便利です。一方、pandasは「商品」「単価」「個数」のように、異なる意味やデータ型の列をまとめて扱うのに適しています。
両者は対立するものではなく、データ分析では組み合わせて使うこともあります。pandasを学ぶためにNumPyを先に習得する必要はありません。
pandasを使う準備
pandasをまだインストールしていない場合は、ターミナルで次のコマンドを実行します。
python -m pip install pandasJupyter Notebookでは、コードセルで%pip install pandasを実行する方法もあります。すでに利用できる環境なら、インストールは不要です。
Pythonから使うときは、次のように読み込みます。
import pandas as pdas pdは、pandasにpdという短い別名を付ける指定です。以降はpd.Series()やpd.DataFrame()と記述します。読み込みだけでは、画面に表などは表示されません。
Seriesとは?1次元のデータを扱う
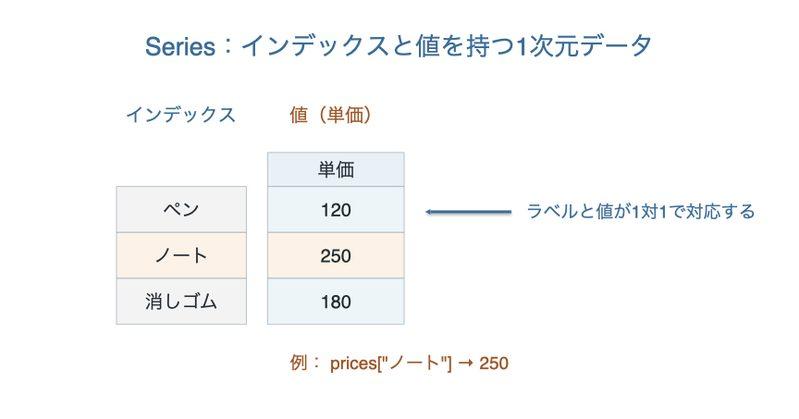
Series(シリーズ)は、値とインデックス(ラベル)を持つ1次元のデータ構造です。
例えば、商品の単価だけをまとめてみましょう。
import pandas as pd

prices = pd.Series(
    [120, 250, 180],
    index=["ペン", "ノート", "消しゴム"],
    name="単価"
)

print(prices)

# 実行結果:
# ペン      120
# ノート     250
# 消しゴム    180
# Name: 単価, dtype: int64左側の「ペン」「ノート」「消しゴム」がインデックス、右側の120・250・180が値です。
index=は各値に対応するラベル、name=はSeries全体の名前を指定しています。末尾のdtype: int64は、値のデータ型が64ビット整数であることを意味します。
インデックスのラベルを使うと、対応する値を取り出せます。
print(prices.loc["ノート"])

# 実行結果:
# 250locはラベルを指定してデータを選ぶ方法です。詳細は別の記事で解説します。
なお、index=を省略した場合、通常は0から始まる整数のインデックスが付けられます。インデックスは必ずしも単なる行番号ではなく、データに付けるラベルだと考えましょう。
DataFrameとは?2次元の表を扱う
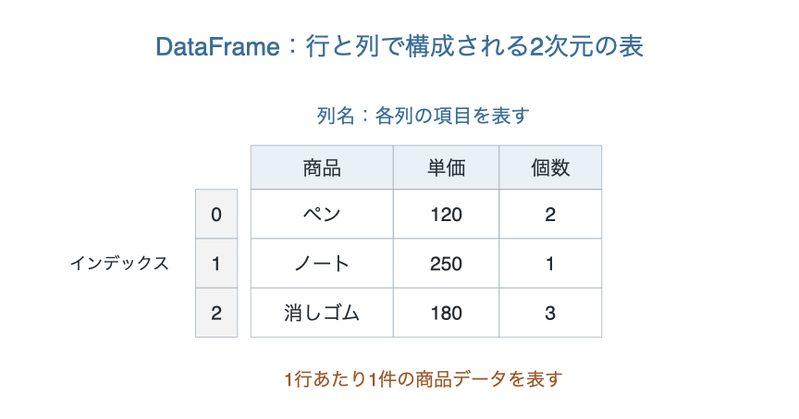
DataFrame(データフレーム)は、行と列からなる2次元の表形式データです。Seriesが1つの項目の並びを扱うのに対し、DataFrameでは複数の項目を1つの表にまとめられます。
import pandas as pd

df = pd.DataFrame({
    "商品": ["ペン", "ノート", "消しゴム"],
    "単価": [120, 250, 180],
    "個数": [2, 1, 3]
})

print(df)

# 実行結果:
#      商品   単価  個数
# 0    ペン  120   2
# 1   ノート  250   1
# 2 消しゴム 180 3ここではPythonの辞書をpd.DataFrame()に渡しました。辞書のキー「商品」「単価」「個数」が列名、各リストの値がそれぞれの列のデータになります。
左端の0・1・2は、DataFrameが自動で付けたインデックスです。「商品」などのデータ列とは別のものなので、混同しないようにしましょう。
DataFrameには、文字列の列と数値の列を一緒に含められます。実際の売上表や顧客一覧のようなデータを扱いやすい理由の1つです。
行・列・インデックスの違い
DataFrameを読み解くには、次の3つを区別することが大切です。
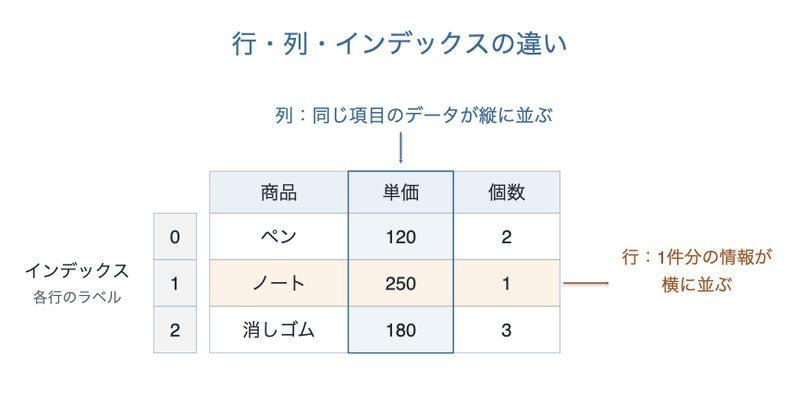
| 用語 | 意味 | 例 |
|---|---|---|
| 行(row) | 横方向に並ぶ、1件分のデータ | 「ノート、250、1」 |
| 列(column) | 縦方向に並ぶ、同じ項目のデータ | 「単価」の120・250・180 |
| インデックス(index) | 各行に付けられたラベル | 0・1・2 |
| 列名(columns) | 各列を識別するラベル | 商品・単価・個数 |
例えば、2行目にはノートの情報が横に並んでいます。一方、「単価」列を縦に見ると、商品ごとの単価が並んでいます。
インデックスと列名は、次のコードで確認できます。
print(df.index.tolist())
print(df.columns.tolist())
print(df.shape)

# 実行結果:
# [0, 1, 2]
# ['商品', '単価', '個数']
# (3, 3)shapeは**(行数, 列数)**を返します。この表は3行3列なので(3, 3)です。インデックスはデータ列数に数えません。
インデックスは文字列に変更することもでき、行を削除したときに0から振り直されるとも限りません。表示上の位置番号とインデックスのラベルは、必ず一致するわけではない点に注意してください。
head()やinfo()など、DataFrameのさまざまな確認方法は別の記事で詳しく解説します。
SeriesとDataFrameの違い
ここまでの内容を整理すると、Seriesは1次元、DataFrameは2次元という違いがあります。
| 比較項目 | Series | DataFrame |
|---|---|---|
| 次元 | 1次元 | 2次元 |
| 基本構造 | インデックスと値 | 行・列のラベルと値 |
| 代表的な作成方法 | pd.Series() | pd.DataFrame() |
| イメージ | 商品ごとの単価 | 商品・単価・個数を持つ表 |
列の選択方法によるSeriesとDataFrameの違い
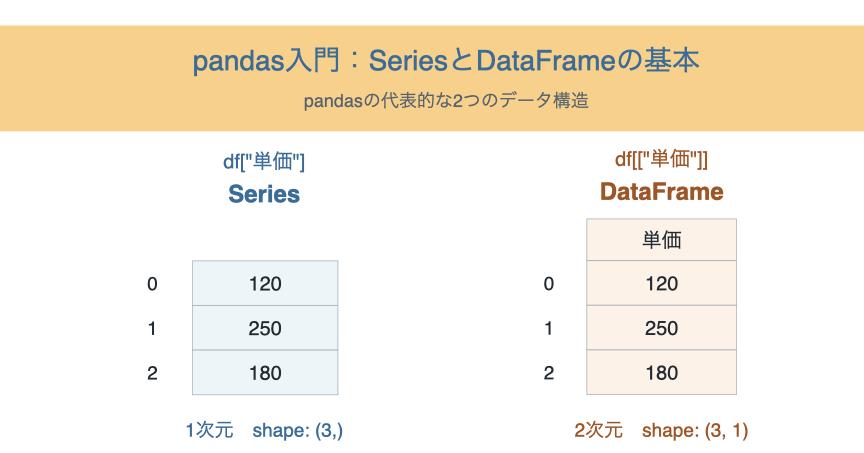
ここは初心者が特に間違えやすいポイントです。DataFrameから同じ「単価」列を選ぶ場合でも、角括弧の書き方によって返されるデータ構造が変わります。
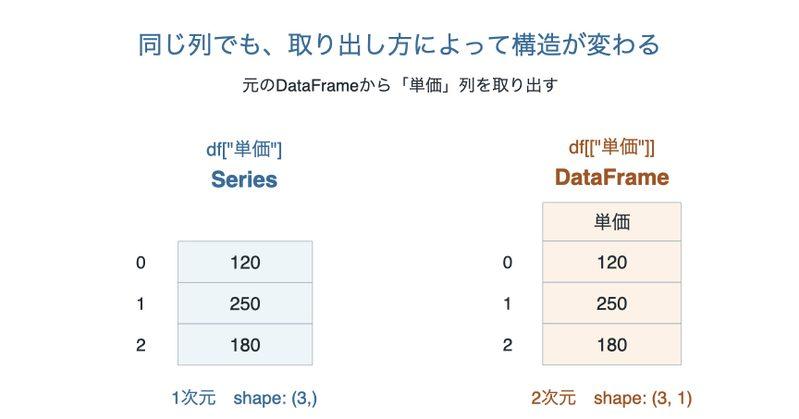
series_col = df["単価"]
dataframe_col = df[["単価"]]

print(type(series_col).__name__, series_col.shape)
print(type(dataframe_col).__name__, dataframe_col.shape)

# 実行結果:
# Series (3,)
# DataFrame (3, 1)df["単価"]は1つの列名を指定するため、通常はSeriesを返します。一方、df[["単価"]]は列名のリストを渡しているため、1列だけのDataFrameを返します(列名が重複していない場合)。
(3,)は要素3個の1次元、(3, 1)は3行1列の2次元です。DataFrameは1列しかなくても2次元であり、Seriesと同じものにはなりません。
pandasを体系的に学びたい方へ
今回の記事では、pandasの基本となるSeriesとDataFrameの構造を解説しました。ただ、実際のデータ分析では表を作るだけでなく、ファイルを読み込み、必要なデータを選び、加工・集計して結果を保存するといった一連の操作が必要になります。
例えば、売上データを分析するなら、最初に列名やデータ型を確認し、欠損値や重複を整理した上で、商品別・店舗別に売上を集計します。操作を個別に覚えるだけでなく、「どの順番で、何のために処理するのか」を理解することが大切です。
そこで、pandasの操作を基礎から順番に学びたい方に向けて、Kindle書籍『機械学習・データ分析のためのpandas入門 ― データ加工と集計の基本をPythonで学ぶ ―』(著者:ぼりたそ)を執筆しました。
本書では、Series・DataFrameの基本から、CSVファイルの読み込み、行・列の選択、条件抽出、欠損値の処理、データ型の変換、groupbyによる集計、複数の表の結合・変形まで、段階的に解説しています。さらに、コード例と演習を組み合わせることで、学んだ操作を自分でも試せる構成にしています。
「Pythonの基本文法は学んだけれど、pandasはこれから」「CSVやExcelのデータをPythonで整理できるようになりたい」という方におすすめです。ブログでは操作ごとの疑問を解決し、書籍ではデータ処理の流れを体系的に身に付ける、という使い分けもできます。
まとめ
今回は、pandasの役割とSeries・DataFrameの基本構造を解説しました。
- pandasは、表形式データの加工・集計に便利なライブラリです。
- Seriesは、インデックスと値を持つ1次元のデータ構造です。
- DataFrameは、行と列で構成される2次元のデータ構造です。
- インデックスは行ラベル、列名は各列を識別するラベルです。
df["単価"]はSeries、df[["単価"]]は1列のDataFrameになります。
次回は、DataFrameの作成方法とデータの確認方法を詳しく解説します。