こんにちは!ぼりたそです!
今回は、pandasを使って欠損値と重複データを処理する方法について解説します。
CSVやExcelから読み込んだデータには、値が入力されていない行や、同じデータが複数回記録されている行が含まれることがあります。
このようなデータを適切に処理せずに分析すると、集計結果や機械学習モデルの予測精度に影響を与える可能性があります。そのため、欠損値や重複データの処理は、データ分析における前処理の重要な操作の一つです。
この記事で学べること
- 欠損値の基本とNaN・pd.NAの違い
isna()による欠損値の確認方法dropna()による欠損値の削除方法fillna()による欠損値の補完方法duplicated()による重複データの確認方法drop_duplicates()による重複データの削除方法- データ処理後のインデックスとデータ型の注意点
Pythonやpandasの基本操作を学習したばかりの方でも理解できるように、サンプルコードと図解を交えながら解説していきます。
欠損値とは?NaNとpd.NAの違い
欠損値とは、値が記録されていない状態を示すものです。例えば、売上が未入力の場合や、アンケートに回答がなかった場合が該当します。
pandasでは、データ型に応じてNaN、pd.NA、None、NaTなどが欠損値として扱われます。初めて使うときは、特に次の2つを区別しておきましょう。
| 表記 | 主な用途・特徴 |
|---|---|
NaN | 数値データなどの欠損値。通常はnumpy.nanで表され、浮動小数点型として扱われます。 |
pd.NA | pandasの欠損値を表す値。欠損を許容する整数型Int64などで利用されます。 |
どちらも欠損値を表し、isna()でまとめて検出できます。ただし、NaNとpd.NAは同じオブジェクトではなく、計算や比較時の動作にも違いがあります。
サンプルのDataFrameを作成する
今回は店舗ごとの売上データを使用します。一部の数値をnp.nanとして空欄にし、同じ内容の行も含めています。
import pandas as pd
import numpy as np

df = pd.DataFrame({
    "商品": ["ペン", "ノート", "ペン", "消しゴム", "定規", "定規", "付せん", "ノート"],
    "店舗": ["東京", "大阪", "東京", "東京", "大阪", "大阪", "東京", "大阪"],
    "売上": [1200, 2500, 1200, np.nan, 1800, 1800, np.nan, 2600],
    "個数": [10, np.nan, 10, 8, 6, 6, np.nan, 9],
})
print(df)

# 実行結果:
#      商品  店舗      売上    個数
# 0    ペン  東京  1200.0  10.0
# 1   ノート  大阪  2500.0   NaN
# 2    ペン  東京  1200.0  10.0
# 3  消しゴム  東京     NaN   8.0
# 4    定規  大阪  1800.0   6.0
# 5    定規  大阪  1800.0   6.0
# 6   付せん  東京     NaN   NaN
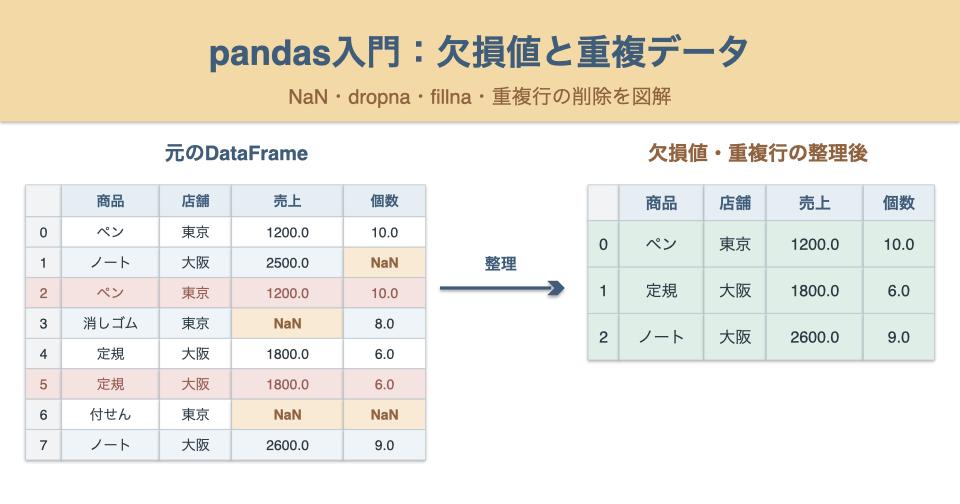
# 7 ノート 大阪 2600.0 9.0左端の0〜7はインデックスです。インデックス0と2、4と5は、すべての列の値が一致する重複行になっています。また、売上・個数には欠損値が含まれています。
DataFrameの基本的な作成・確認方法は、こちらの記事でも紹介しています。
isna()で欠損値を確認する
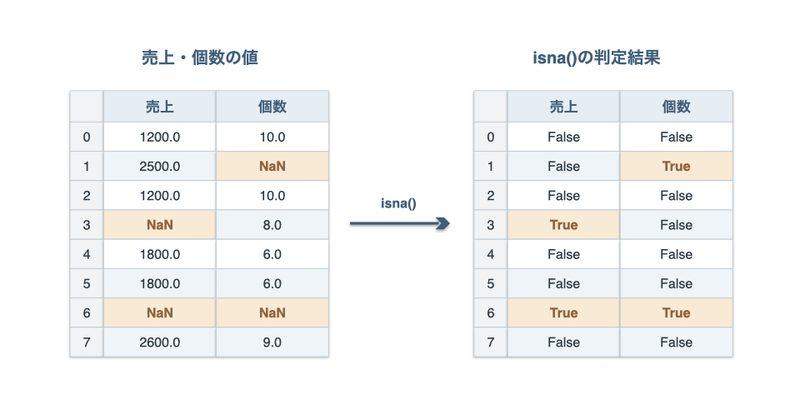
df.isna()は、DataFrameの各セルが欠損値かどうかを判定します。欠損値ならTrue、通常の値ならFalseです。
print(df.isna())

# 実行結果:
#       商品     店舗     売上     個数
# 0  False  False  False  False
# 1  False  False  False   True
# 2  False  False  False  False
# 3  False  False   True  False
# 4  False  False  False  False
# 5  False  False  False  False
# 6  False  False   True   True
# 7 False False False False例えば、インデックス1の「個数」、インデックス3の「売上」、インデックス6の「売上」と「個数」がTrueになります。Trueは削除対象を決めているのではなく、欠損値の位置を示す判定結果です。
各列に欠損値がいくつあるかを数えるには、isna()の後にsum()をつなげます。
print(df.isna().sum())

# 実行結果:
# 商品    0
# 店舗    0
# 売上    2
# 個数    2
# dtype: int64このDataFrameでは「売上」と「個数」にそれぞれ2個の欠損値があり、「商品」と「店舗」にはありません。ここではTrueを1、Falseを0として合計しています。
pd.NAを使う整数型の例
通常の数値列にNaNが入ると、整数だった値も1200.0のように表示され、列の型がfloat64になることがあります。一方、欠損値を許容する整数型Int64(先頭が大文字のI)なら、欠損があっても整数型として扱えます。
s = pd.Series([10, pd.NA, 30], dtype="Int64")
print(s)
print("データ型:", s.dtype)

# 実行結果:
# 0      10
# 1    <NA>
# 2      30
# dtype: Int64
# データ型: Int64ここでの<NA>は欠損値を示し、dtype: Int64が欠損を許容する整数型であることを表します。int64とInt64は、欠損値を許容するかどうかが異なります。欠損値を0や空文字に置き換えることとは別の処理です。
dropna()で欠損値のある行を削除する
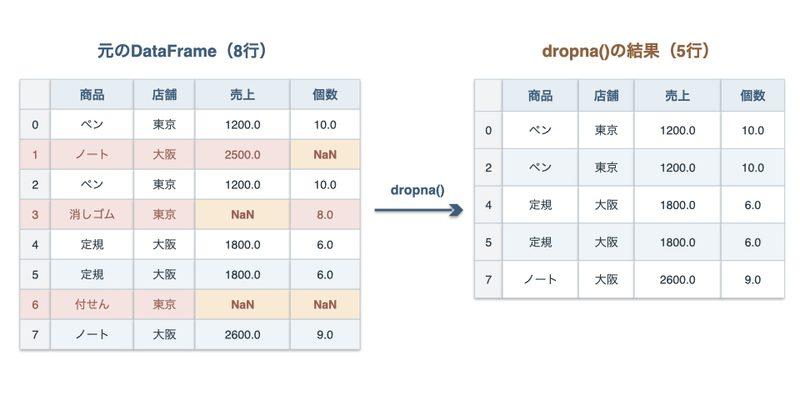
dropna()は、欠損値を含む行や列を削除するためのメソッドです。df.dropna()と書くと、いずれかの列に欠損値がある行を削除した、新しいDataFrameが返されます。
print(df.dropna())

# 実行結果:
#     商品  店舗      売上    個数
# 0   ペン  東京  1200.0  10.0
# 2   ペン  東京  1200.0  10.0
# 4   定規  大阪  1800.0   6.0
# 5   定規  大阪  1800.0   6.0
# 7 ノート 大阪 2600.0 9.0欠損値があるインデックス1、3、6の行が除かれ、0、2、4、5、7の5行が残りました。元のdfは変更されず、残った行のインデックスはそのままです。
特定の列だけを基準に削除する
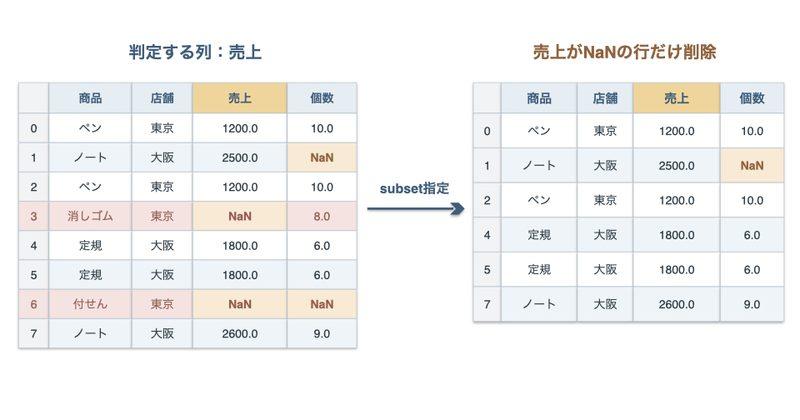
商品名や店舗はそろっていても、「売上」が未入力の行だけ除きたい場合があります。そのときはsubsetで判定に使用する列を指定します。
print(df.dropna(subset=["売上"]))

# 実行結果:
#     商品  店舗      売上    個数
# 0   ペン  東京  1200.0  10.0
# 1  ノート  大阪  2500.0   NaN
# 2   ペン  東京  1200.0  10.0
# 4   定規  大阪  1800.0   6.0
# 5   定規  大阪  1800.0   6.0
# 7 ノート 大阪 2600.0 9.0subset=["売上"]では「売上」が欠損している行だけが削除されます。したがって、「個数」が欠損しているインデックス1は残ります。subsetは表示する列を選ぶ指定ではなく、欠損を判定する列を選ぶ指定です。
2列とも欠損している場合に限って行を削除したいときは、how="all"を組み合わせます。
print(df.dropna(subset=["売上", "個数"], how="all"))

# 実行結果:
#      商品  店舗      売上    個数
# 0    ペン  東京  1200.0  10.0
# 1   ノート  大阪  2500.0   NaN
# 2    ペン  東京  1200.0  10.0
# 3  消しゴム  東京     NaN   8.0
# 4    定規  大阪  1800.0   6.0
# 5    定規  大阪  1800.0   6.0
# 7 ノート 大阪 2600.0 9.0この例では「売上」と「個数」の両方が欠損しているインデックス6だけが削除されます。how="any"(既定値)は指定列のどれか1つでも欠損なら削除、how="all"は指定列がすべて欠損なら削除、という違いです。
fillna()で欠損値を補完する
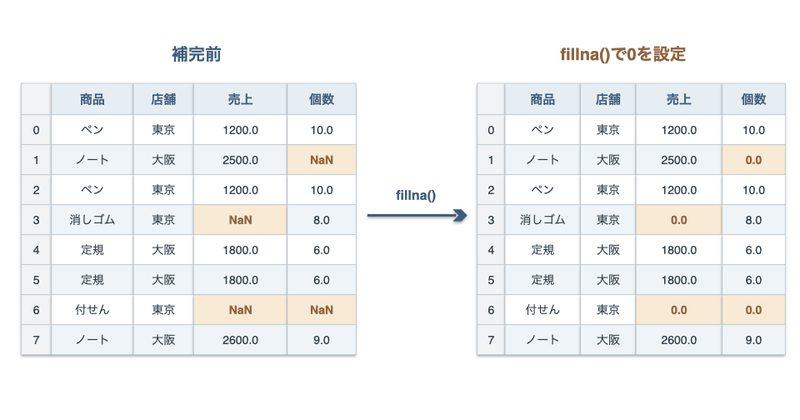
欠損値がある行を削除すると、必要なデータまで失われることがあります。行を残したい場合はfillna()で欠損値を別の値に置き換えます。
0で補完する
以下では、「売上」と「個数」の欠損値を0に置き換えます。
df_filled = df.fillna({"売上": 0, "個数": 0})
print(df_filled)

# 実行結果:
#      商品  店舗      売上    個数
# 0    ペン  東京  1200.0  10.0
# 1   ノート  大阪  2500.0   0.0
# 2    ペン  東京  1200.0  10.0
# 3  消しゴム  東京     0.0   8.0
# 4    定規  大阪  1800.0   6.0
# 5    定規  大阪  1800.0   6.0
# 6   付せん  東京     0.0   0.0
# 7 ノート 大阪 2600.0 9.0欠損していたセルに0.0が入り、行数は8行のままです。ここでは、元の2列が浮動小数点型float64なので、補完後も0.0と表示されます。
注意:欠損値=0とは限りません。 未入力の売上を0円として扱ってよいかは、データの意味によって変わります。「不明」と「実際に売上が0円」は異なるため、根拠なく0で補完しないことが大切です。
中央値で補完する
数値データでは、平均値や中央値などで補完する方法もあります。ここでは「売上」の欠損値だけを中央値で置き換えます。
median_sales = df["売上"].median()
df_median = df.copy()
df_median["売上"] = df_median["売上"].fillna(median_sales)
print("売上の中央値:", median_sales)
print(df_median[["商品", "売上"]])

# 実行結果:
# 売上の中央値: 1800.0
#      商品      売上
# 0    ペン  1200.0
# 1   ノート  2500.0
# 2    ペン  1200.0
# 3  消しゴム  1800.0
# 4    定規  1800.0
# 5    定規  1800.0
# 6   付せん  1800.0
# 7 ノート 2600.0売上の中央値は1,800円なので、売上が欠損していた2行に1800.0が入ります。「個数」の欠損値はそのままです。中央値は極端に大きい値の影響を平均値より受けにくいものの、補完方法は分析目的に応じて選ぶ必要があります。
duplicated()で重複行を確認する
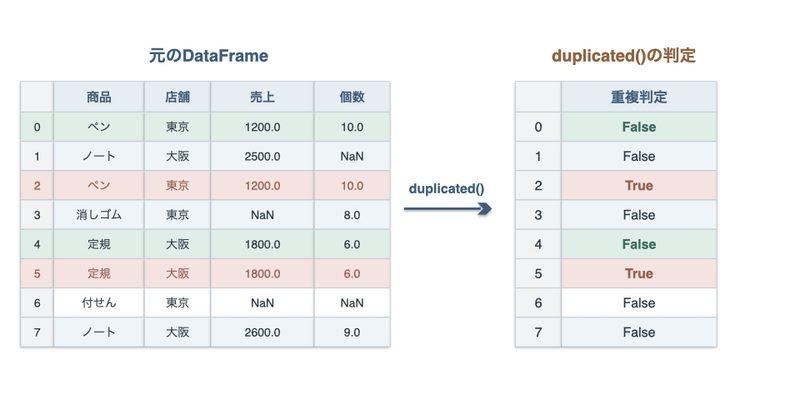
重複行とは、比較対象とした列の値が同じ行が複数存在する状態です。df.duplicated()は、すべての列を比較し、重複を真偽値で返します。
print(df.duplicated())

# 実行結果:
# 0    False
# 1    False
# 2     True
# 3    False
# 4    False
# 5     True
# 6    False
# 7    False
# dtype: bool既定のkeep="first"では、最初に出現した行はFalse、2回目以降に出現した同じ行がTrueになります。このデータではインデックス2が0と、5が4と同じ内容なのでTrueです。
値が同じだけで誤登録とは限りません。 同じ商品が別の日に売れたデータなどは正当な記録の場合があります。重複と判定する列はデータの意味を確認して決めましょう。
drop_duplicates()で重複行を削除する
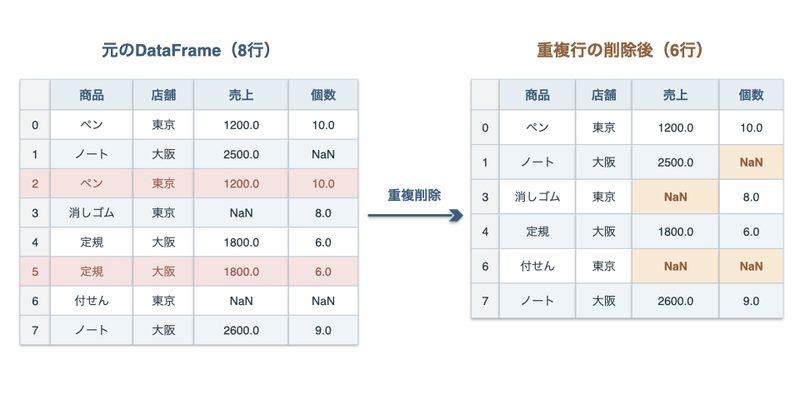
drop_duplicates()は、重複した行のうち、既定では最初の1行を残して後続の行を削除します。
df_unique = df.drop_duplicates()
print(df_unique)

# 実行結果:
#      商品  店舗      売上    個数
# 0    ペン  東京  1200.0  10.0
# 1   ノート  大阪  2500.0   NaN
# 3  消しゴム  東京     NaN   8.0
# 4    定規  大阪  1800.0   6.0
# 6   付せん  東京     NaN   NaN
# 7 ノート 大阪 2600.0 9.0インデックス2と5が削除され、0、1、3、4、6、7が残ります。欠損値がある行はこの操作では削除されません。重複の削除と欠損値の削除は別の処理です。
比較する列と残す行を指定する
特定の列だけを重複判定の基準にしたい場合はsubset、後の行を残したい場合はkeep="last"を指定します。
print(df.drop_duplicates(subset=["商品", "店舗"], keep="last"))

# 実行結果:
#      商品  店舗      売上    個数
# 2    ペン  東京  1200.0  10.0
# 3  消しゴム  東京     NaN   8.0
# 5    定規  大阪  1800.0   6.0
# 6   付せん  東京     NaN   NaN
# 7   ノート  大阪  2600.0   9.0
この例では「商品」と「店舗」の組み合わせが同じ行を重複とみなします。インデックス1と7は売上が異なっていても同じ組み合わせなので、最後の7が残ります。0と2では2が、4と5では5が残ります。
「商品」と「店舗」が同じだけで、本当に重複登録とは限りません。売上を記録する日付や取引番号がある場合は、それらも含めて判定するとよいでしょう。
削除後のインデックスとデータ型に注意する
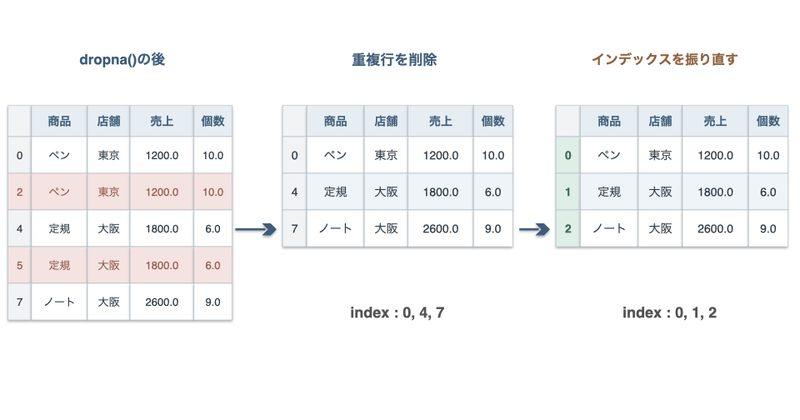
欠損値と重複行を順番に削除しても、元のインデックスは自動的に0から連番になりません。連番にしたい場合はreset_index(drop=True)を使います。
cleaned = (df.dropna(subset=["売上", "個数"])
             .drop_duplicates()
             .reset_index(drop=True))
print(cleaned)

# 実行結果:
#     商品  店舗      売上    個数
# 0   ペン  東京  1200.0  10.0
# 1   定規  大阪  1800.0   6.0
# 2 ノート 大阪 2600.0 9.0ここでは、欠損値のある行を削除し、重複行を取り除いてから、インデックスを0、1、2に振り直しました。drop=Trueを指定すると、古いインデックスを新しい列として残しません。
欠損値を削除しても型が自動で整数には戻らない
欠損値を含む数値列はfloat64になる場合があります。欠損値を削除しても、データ型が自動的にint64へ戻るわけではありません。
print("元の個数:", df["個数"].dtype)
print("整理後の個数:", cleaned["個数"].dtype)
cleaned["個数"] = cleaned["個数"].astype("int64")
print("整数へ変換後:", cleaned["個数"].dtype)

# 実行結果:
# 元の個数: float64
# 整理後の個数: float64
# 整数へ変換後: int64astype("int64")は、この例のように欠損値がなく、整数へ安全に変換できる値だけの場合に使えます。欠損値を残したまま整数型で管理したいときはInt64も選択肢です。
nullable_quantity = df["個数"].astype("Int64")
print(nullable_quantity)
print("データ型:", nullable_quantity.dtype)

# 実行結果:
# 0      10
# 1    <NA>
# 2      10
# 3       8
# 4       6
# 5       6
# 6    <NA>
# 7       9
# Name: 個数, dtype: Int64
# データ型: Int64ここでは、欠損値が<NA>として残り、整数値は10や8のように小数点なしで表示されます。
なお、dropna()、fillna()、drop_duplicates()は、通常元のDataFrameを変更せず、新しいDataFrameを返すメソッドです。元の値を保持したい場合は、今回のようにdf_clean = ...などの別変数で結果を受け取ると操作の流れを追いやすくなります。
pandas入門書の紹介
今回は、欠損値と重複データを確認・処理する基本操作を学びました。実際のデータ分析では、CSVの読み込みから欠損値処理、列の追加、条件抽出、集計までを組み合わせて使います。
これらを基礎から体系的に学びたい方に向けて、Kindle書籍**『機械学習・データ分析のためのpandas入門 ― データ加工と集計の基本をPythonで学ぶ ―』**(著者:ぼりたそ)を執筆しました。
本書では、DataFrameの基本操作からデータ加工・集計までを図解やコード、演習を通じて順番に学べます。ブログで個別の疑問を解決し、書籍では一連の処理を練習したい方におすすめです。
まとめ
今回は、pandasの欠損値と重複データの処理方法を解説しました。
isna()で欠損値の場所を確認し、isna().sum()で列ごとの数を数えられます。dropna()で欠損値を含む行を削除し、subsetで判定に使用する列を指定できます。fillna()で値を補完できますが、「欠損」と「0」の違いに注意が必要です。duplicated()で重複行を判定し、drop_duplicates()で重複した行を削除できます。- 削除後のインデックスは自動的に振り直されず、数値列のデータ型も自動的には変換されません。
欠損値・重複の処理には、データの意味に応じた判断が必要です。まずは今回のサンプルで各操作を実行し、どの行が残り、どの値が変わったかを確認してみてください。