こんにちは!ぼりたそです!
今回は、pandasのDataFrameから行や列を取り出すときに使うlocとilocについて解説します。
どちらもデータを選択するための機能ですが、locは行・列のラベル、ilocは0から始まる位置番号を使います。見た目が似ているため、違いが分からないまま使うと、意図しない行を選んだり、スライスの範囲を間違えたりすることがあります。
この記事では、身近な売上データを使いながら、行・列の選択、スライスの終端、戻り値の違いまで図解とコードで確認します。
この記事で学べること
locとilocの基本的な違い- 1行・複数行・列を選択する方法
- スライスの終端と、
Series・DataFrameの戻り値の違い - 整数のインデックスを使う場合の注意点
locとilocの違い
まず、それぞれが何を基準にデータを選ぶのかを押さえましょう。
| 操作 | 選択する基準 | 書き方の例 |
|---|---|---|
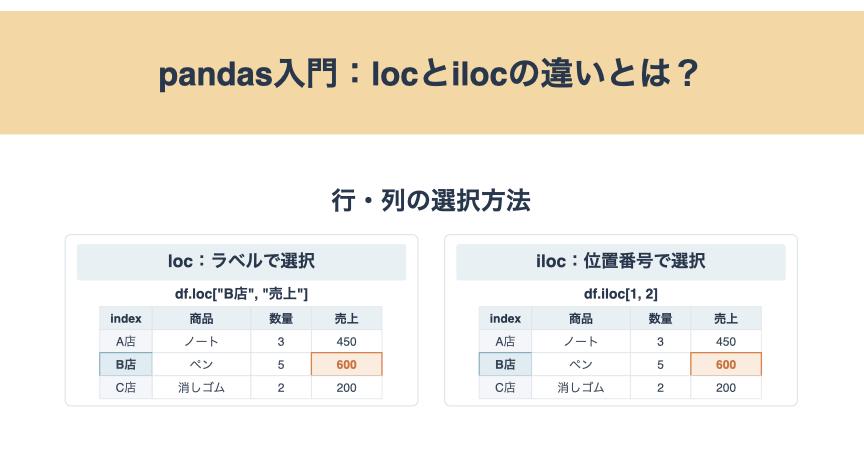
loc | 行ラベル・列名 | df.loc["B店", "売上"] |
iloc | 0から始まる行・列の位置番号 | df.iloc[1, 2] |
基本の書き方は、どちらもdf.loc[行, 列]、df.iloc[行, 列]です。カンマの前で行、後で列を指定します。列を省略すると、指定した行のすべての列が対象になります。
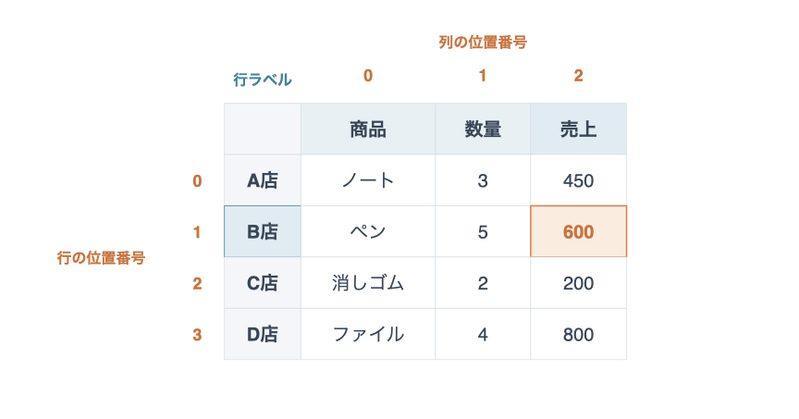
例えば、行ラベルが「B店」の行は上から2番目でも、位置番号では1です。Pythonの位置番号は0から始まるためです。
使用するDataFrameを作成する
以下のコードで、店舗別の商品の数量と売上をまとめた表を作成します。行のインデックスには、A店〜D店というラベルを設定します。
import pandas as pd

df = pd.DataFrame(
    {
        "商品": ["ノート", "ペン", "消しゴム", "ファイル"],
        "数量": [3, 5, 2, 4],
        "売上": [450, 600, 200, 800],
    },
    index=["A店", "B店", "C店", "D店"],
)

print(df)

# 実行結果:
#       商品  数量   売上
# A店   ノート   3  450
# B店    ペン   5  600
# C店  消しゴム   2  200
# D店 ファイル 4 800A店〜D店が行ラベル、商品・数量・売上が列名です。これらのラベルは、行や列が並んでいる位置そのものとは異なります。
DataFrameの作り方やインデックスの基本は、DataFrameの作成とデータの確認方法でも解説しています。
locで行・列を選択する
locは、行ラベルや列名を指定して選択する方法です。どの店舗・項目が必要か分かっているときに便利です。
1行を選択する
print(df.loc["B店"])

# 実行結果:
# 商品     ペン
# 数量      5
# 売上    600
# Name: B店, dtype: objectdf.loc["B店"]で「B店」の行を選択できます。1つの行ラベルを指定すると、結果は通常Seriesになります。出力のName: B店は、取り出した行のラベルです。
複数の行を選択する
print(df.loc[["A店", "C店"]])

# 実行結果:
#       商品  数量   売上
# A店   ノート   3  450
# C店 消しゴム 2 200行ラベルをリストで渡すと、離れた行もまとめて選べます。[[...]]の外側の[]はlocの指定、内側の[]はラベルを並べたリストです。
列を選択する
print(df.loc[:, ["商品", "売上"]])

# 実行結果:
#       商品   売上
# A店   ノート  450
# B店    ペン  600
# C店  消しゴム  200
# D店 ファイル 800先頭の:は「すべての行」を意味します。df.loc[:, ["商品", "売上"]]では全行を残したまま、指定した2列だけを取り出します。
行と列を同時に選択する
print(df.loc["B店":"C店", ["商品", "売上"]])

# 実行結果:
#       商品   売上
# B店    ペン  600
# C店  消しゴム  200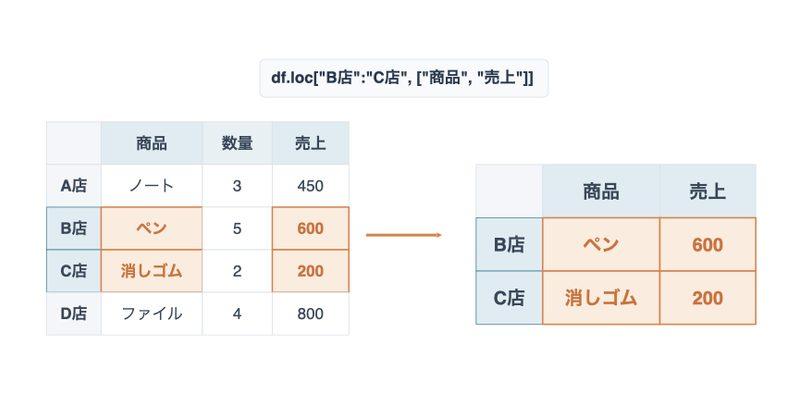
この例では、B店からC店までの行と、「商品」「売上」の列を組み合わせて選択しています。locのラベルによるスライスでは、基本的に終了側のラベルも含まれます。
ilocで行・列を選択する
ilocは、0から始まる位置番号で選択する方法です。「上から2行目」「左から1列目」のように、並び順で指定したいときに使います。
今回のDataFrameでは、A店〜D店の行位置は0〜3、商品・数量・売上の列位置は0〜2です。
1行を選択する
print(df.iloc[1])

# 実行結果:
# 商品     ペン
# 数量      5
# 売上    600
# Name: B店, dtype: object行位置1は、上から2行目のB店です。df.loc["B店"]と同じデータを選んでいますが、指定方法が異なります。
連続した行を選択する
print(df.iloc[1:3])

# 実行結果:
#       商品  数量   売上
# B店    ペン   5  600
# C店 消しゴム 2 2001:3は、位置1以上・位置3未満を表します。したがって、選ばれるのは位置1と2、つまりB店とC店です。
行と列を同時に選択する
print(df.iloc[1:3, [0, 2]])

# 実行結果:
#       商品   売上
# B店    ペン  600
# C店  消しゴム  200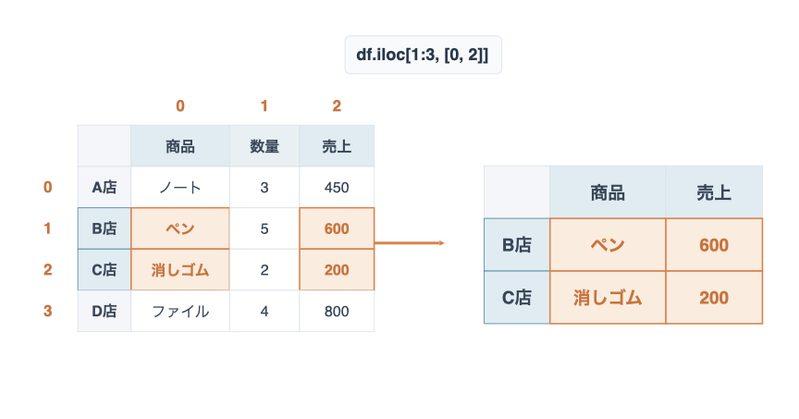
行は1:3、列は[0, 2]として指定しています。列位置0が「商品」、列位置2が「売上」です。この結果は、先ほどのlocによる選択と同じになります。
locとilocではスライスの終了位置が違う
最も間違えやすいのが、スライスの終端です。
| 操作 | 指定した範囲 | 実際に選択される行 |
|---|---|---|
df.loc["B店":"C店"] | B店からC店まで | B店、C店(C店を含む) |
df.iloc[1:3] | 位置1から3の直前まで | 位置1、2(位置3は含まない) |
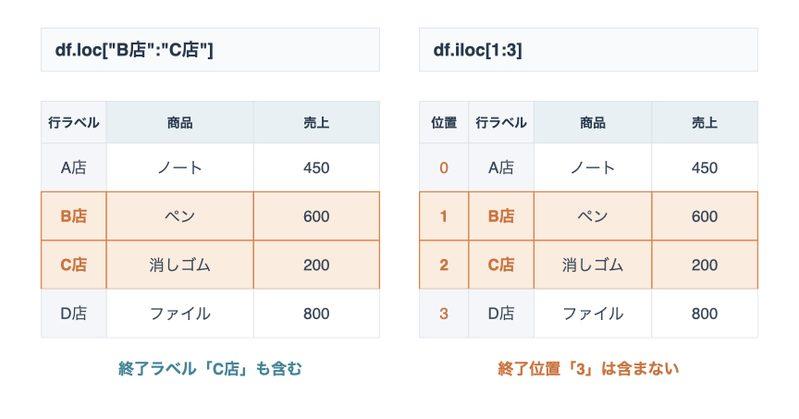
locの"B店":"C店"はラベルで範囲を指定するため、終了側の「C店」も含みます。一方、ilocの1:3はPythonの通常のスライスと同じで、終了位置の3は含みません。
locは終了ラベルを含む、ilocは終了位置番号を含まない、という違いを押さえておくと混乱しにくくなります。
なお、ラベルが並んでいない場合や重複している場合のスライスは、インデックスの状態によって動作が複雑になるため、まずは今回のような順序のはっきりした表で基本を理解しましょう。
1行を選ぶ場合と複数行を選ぶ場合の違い
行を1つだけ選ぶ場合でも、指定方法によって戻り値の種類が変わります。
print(type(df.loc["B店"]).__name__)
print(type(df.loc[["B店"]]).__name__)
print(type(df.iloc[1]).__name__)
print(type(df.iloc[[1]]).__name__)

# 実行結果:
# Series
# DataFrame
# Series
# DataFrame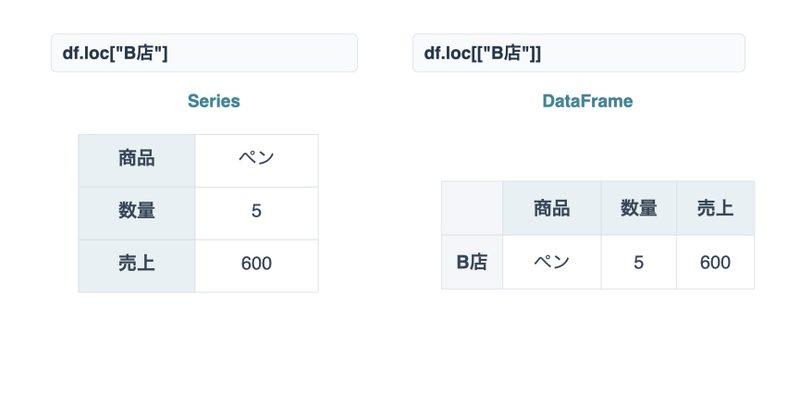
df.loc["B店"]では行を1つのラベルで指定するためSeriesとなり、df.loc[["B店"]]ではラベルをリストで指定するため1行のDataFrameとなります。ilocでも同じように、1ならSeries、[1]ならDataFrameです。
この違いは、選択した後に別のDataFrameと結合したり、表として処理を続けたりするときに重要です。
また、行と列をそれぞれ1つ指定した場合は、1つの値を取得できます。
print(df.loc["B店", "売上"])
print(df.iloc[1, 2])

# 実行結果:
# 600
# 600
行ラベルが整数の場合は特に注意する
インデックスが数値の場合、locとilocの違いが分かりにくくなることがあります。
numbered_df = df.copy()
numbered_df.index = [10, 20, 30, 40]

print(numbered_df.loc[20, "売上"])
print(numbered_df.iloc[1, 2])

# 実行結果:
# 600
# 600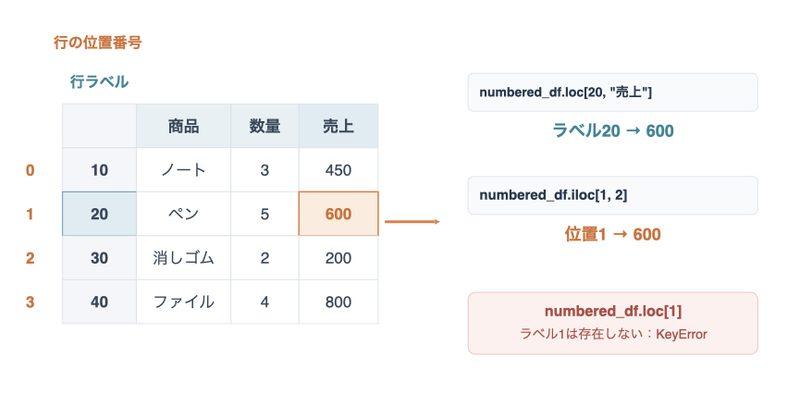
numbered_df.loc[20, "売上"]の20は行ラベル20を意味します。一方、numbered_df.iloc[1, 2]の1は2行目の位置番号1です。この表でnumbered_df.loc[1]と書いても、ラベル1の行がないためKeyErrorになります。
デフォルトのインデックスが0、1、2…の場合は両者が同じ行を示すこともありますが、locが位置番号で選択しているわけではありません。
よくある間違いと使い分け
df.loc["E店"]:その行ラベルがなければKeyErrorになります。df.iloc[4]:今回のDataFrameは4行なので、位置4は範囲外となりIndexErrorになります。df.iloc["B店"]:ilocでは行ラベルの文字列を指定できません。df.iloc[1:3]:3行目までではなく、位置1と2の2行を選びます。
実際に使う際は、**「名前で選びたいならloc、何番目かで選びたいならiloc」**と考えると分かりやすくなります。列をすべて選ぶ場合には、どちらも:を使えます。
今回扱ったのはラベルや位置による選択です。例えば「売上が500円以上の行だけを選ぶ」といった値による絞り込みは、条件抽出という別の操作になります。
pandas入門書の紹介
この記事では、locとilocを使った行・列の取り出し方を学びました。実際のデータ分析では、こうした選択操作に加えて、CSV・Excelの読み込み、条件抽出、欠損値の処理、集計などを組み合わせて使います。
これらを基礎から体系的に学びたい方に向けて、Kindle書籍**『機械学習・データ分析のためのpandas入門 ― データ加工と集計の基本をPythonで学ぶ ―』**(著者:ぼりたそ)を執筆しました。
本書では、Series・DataFrameの基本から、データの読み込み、加工、集計、結合・変形までを、具体的なコード例と演習を通して段階的に学べます。ブログで個々の操作を確認しながら、書籍で全体の流れを身につけたい方におすすめです。
まとめ
今回は、locとilocによる行・列の選択方法を解説しました。
loc:行ラベル・列名を指定して選択する。iloc:0から始まる行・列の位置番号を指定して選択する。- スライス:
locは終了ラベルを含み、ilocは終了位置番号を含まない。 - 戻り値:1行を単独指定すると
Series、リストで指定するとDataFrameになる。 - 整数の行ラベル:
loc[20]の20は位置ではなくラベルを意味する。
locとilocを使い分けられるようになると、必要な範囲のデータを迷わず取り出せます。まずは小さなDataFrameで、指定した行・列と実行結果を見比べてみてください。