こんにちは!ぼりたそです!
今回は、pandasのDataFrameから条件に合う行だけを取り出す方法を解説します。
例えば、売上データから「売上が3,000円以上の商品」「東京店のデータ」「大阪店で売上が3,000円以上のデータ」を探したい場合、条件抽出を使えば必要な行をまとめて取り出せます。
この記事で学べること
- 比較演算子を使った数値・文字列の条件抽出
&(AND)・|(OR)・~(NOT)による複数条件の指定isin()を使った複数候補の抽出- 条件に合う行と必要な列を同時に選択する方法
Pythonの基本文法が分かれば読み進められます。順番に確認していきましょう!
条件抽出とは?
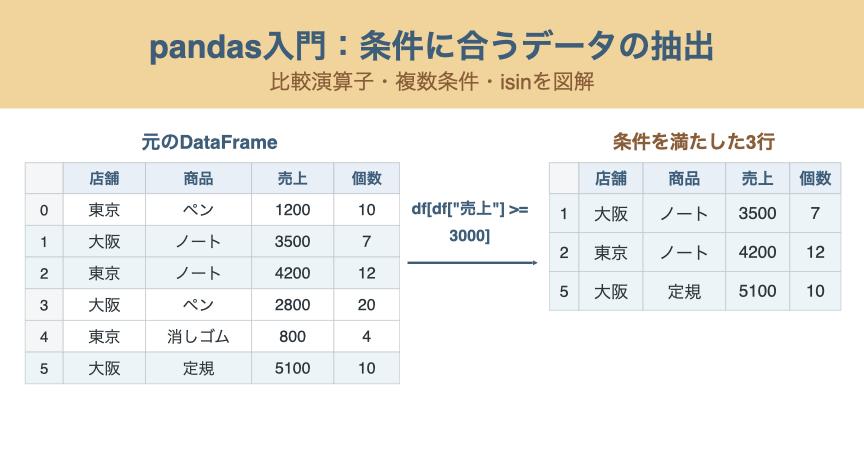
条件抽出は、DataFrameの各行について条件を判定し、条件を満たす行だけを残す操作です。
基本の書き方はdf[条件式]です。
例えばdf["売上"] >= 3000と書くと、各行の「売上」が3,000以上かどうかを調べます。判定結果はTrue(条件を満たす)またはFalse(満たさない)です。この判定結果をdf[...]の中に指定すると、Trueに対応する行だけが抽出されます。
使用するDataFrameを作成する
この記事では、店舗ごとの商品売上を例にします。以下のコードを実行すると、6行4列のDataFrameが作成されます。
import pandas as pd

df = pd.DataFrame({
    "店舗": ["東京", "大阪", "東京", "大阪", "東京", "大阪"],
    "商品": ["ペン", "ノート", "ノート", "ペン", "消しゴム", "定規"],
    "売上": [1200, 3500, 4200, 2800, 800, 5100],
    "個数": [10, 7, 12, 20, 4, 10],
})

print(df)

# 実行結果:
#    店舗    商品    売上  個数
# 0  東京    ペン  1200  10
# 1  大阪   ノート  3500   7
# 2  東京   ノート  4200  12
# 3  大阪    ペン  2800  20
# 4  東京  消しゴム   800   4
# 5  大阪    定規  5100  10
左端の0〜5はインデックス(各行のラベル)です。「店舗」「商品」「売上」「個数」の4つがデータ列に当たります。
DataFrameの作成や確認方法については、こちらの記事も参考にしてください。
比較演算子で条件を指定する
数値を条件にするときは、Pythonと同じ比較演算子を使用します。
| 演算子 | 意味 | 例 |
|---|---|---|
== | 等しい | df["売上"] == 3000 |
!= | 等しくない | df["店舗"] != "東京" |
> | より大きい | df["売上"] > 3000 |
>= | 以上 | df["売上"] >= 3000 |
< | より小さい | df["売上"] < 3000 |
<= | 以下 | df["売上"] <= 3000 |
=は値の代入に使う記号なので、「等しいか」を比較するときは==と2つ並べます。また、3000を含むかどうかによって、>と>=の抽出結果が変わります。
条件式による判定
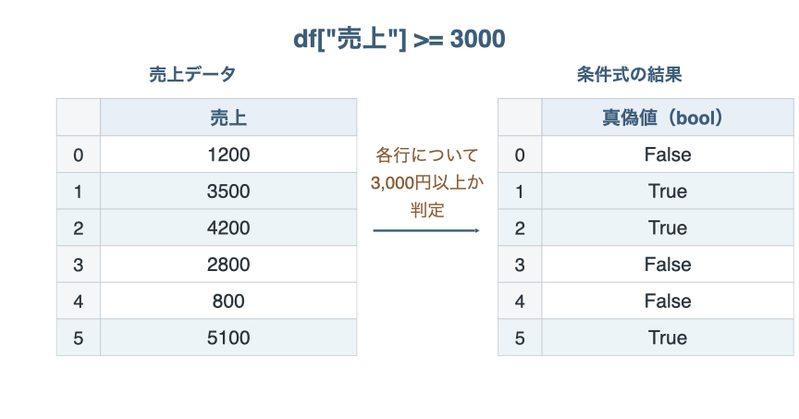
最初に、売上が3,000円以上かどうかだけを判定してみましょう。
condition = df["売上"] >= 3000
print(condition)

# 実行結果:
# 0    False
# 1     True
# 2     True
# 3    False
# 4    False
# 5     True
# Name: 売上, dtype: bool1行目の売上1,200円は条件を満たさないためFalse、2行目の3,500円はTrueです。
dtype: boolは、真偽値を扱うデータ型であることを表します。判定結果には元のDataFrameと同じインデックスが付いています。
数値条件で行を抽出する
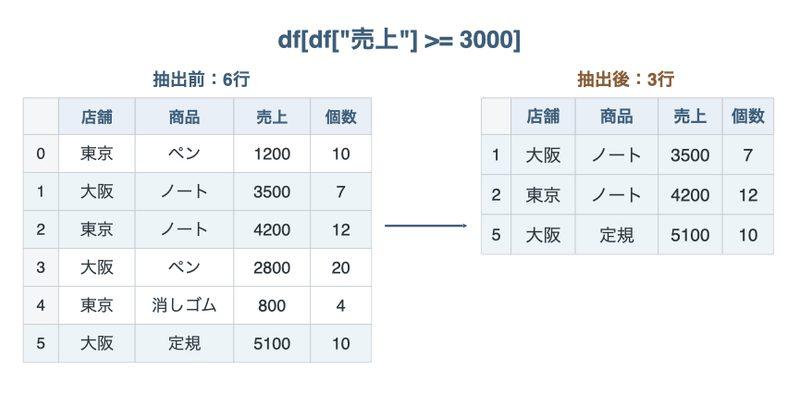
判定結果をDataFrameの角括弧に渡すと、Trueの行だけを残せます。
filtered = df[df["売上"] >= 3000]
print(filtered)

# 実行結果:
#    店舗   商品    売上  個数
# 1  大阪  ノート  3500   7
# 2  東京  ノート  4200  12
# 5  大阪   定規  5100  10
売上が3,000円以上の3行だけが残りました。
条件抽出では基本的に行が選ばれ、列は元のままです。また、抽出後のインデックスは1、2、5のままで、自動的に0から振り直されるわけではありません。
文字列を条件にして抽出する
文字列も==で比較できます。「東京店」の行だけ取り出す例を見てみましょう。
print(df[df["店舗"] == "東京"])

# 実行結果:
#    店舗    商品    売上  個数
# 0  東京    ペン  1200  10
# 2  東京   ノート  4200  12
# 4 東京 消しゴム 800 4文字列は"東京"のように引用符で囲みます。==による比較は基本的に文字列全体の一致を調べるため、「東京本店」のような別の文字列は一致しません。
一部の文字列を含む行を探すときは、str.contains()を利用できます。
print(df[df["商品"].str.contains("ノート")])

# 実行結果:
#    店舗   商品    売上  個数
# 1  大阪  ノート  3500   7
# 2  東京  ノート  4200  12
ここでは「商品」列に「ノート」を含む行が抽出されます。
対象列に欠損値が混じる場合は、str.contains("ノート", na=False)のように指定すると、欠損値を一致しないものとして扱えます。
複数条件で抽出する:AND・OR・NOT
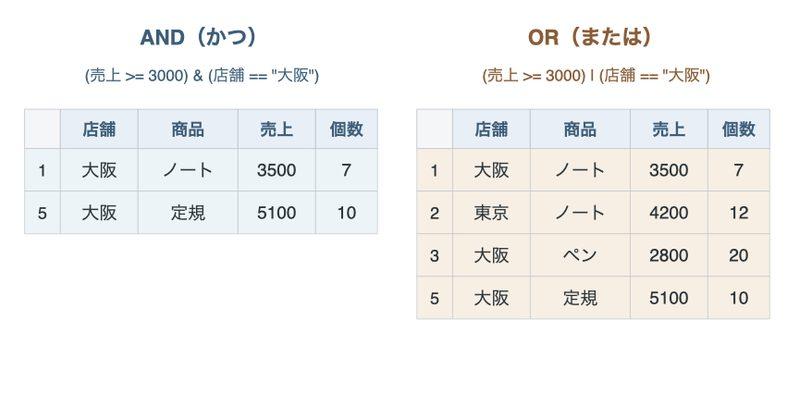
実際のデータ分析では、「売上が3,000円以上かつ大阪店」といった複数条件を使うことが多くあります。
pandasでは、条件ごとに丸括弧()を付け、専用の演算子でつなぎます。
| 条件の組み合わせ | 演算子 | 意味 |
|---|---|---|
| AND(かつ) | & | 両方の条件を満たす |
| OR(または) | | | 少なくとも一方を満たす |
| NOT(否定) | ~ | 条件を満たさない |
AND:両方の条件を満たす行
「売上が3,000円以上」かつ「大阪店」のデータを抽出します。
and_result = df[(df["売上"] >= 3000) & (df["店舗"] == "大阪")]
print(and_result)

# 実行結果:
#    店舗   商品    売上  個数
# 1  大阪  ノート  3500   7
# 5 大阪 定規 5100 10売上条件と店舗条件の両方を満たすのは、インデックス1と5の行です。東京店の4,200円の行は売上条件を満たしても、店舗条件を満たさないので含まれません。
OR:どちらかの条件を満たす行
「売上が3,000円以上」または「大阪店」のデータを抽出します。
or_result = df[(df["売上"] >= 3000) | (df["店舗"] == "大阪")]
print(or_result)

# 実行結果:
#    店舗   商品    売上  個数
# 1  大阪  ノート  3500   7
# 2  東京  ノート  4200  12
# 3  大阪   ペン  2800  20
# 5  大阪   定規  5100  10
売上が3,000円未満でも、大阪店であれば残ります。逆に東京店でも、売上が3,000円以上なら残ります。
NOT:条件を満たさない行
~は条件の真偽を反転させる演算子です。「東京店ではない行」は次のように指定できます。
print(df[~(df["店舗"] == "東京")])

# 実行結果:
#    店舗   商品    売上  個数
# 1  大阪  ノート  3500   7
# 3  大阪   ペン  2800  20
# 5 大阪 定規 5100 10~は(df["店舗"] == "東京")の結果を反転させています。この例はdf["店舗"] != "東京"と書いても同じ結果になります。
注意: DataFrameの条件を組み合わせる際には、通常のPythonで使うand・or・notではなく、&・|・~を使います。各条件を丸括弧で囲まないと、演算の優先順位によってエラーや意図しない判定につながることがあります。
isin()で複数の候補から抽出する
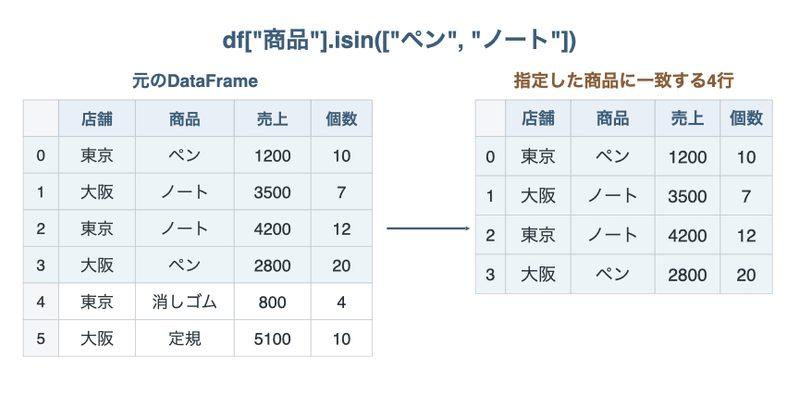
「ペンまたはノート」のように、1つの列で複数の値を候補として指定する場合はisin()が便利です。
print(df[df["商品"].isin(["ペン", "ノート"])])

# 実行結果:
#    店舗   商品    売上  個数
# 0  東京   ペン  1200  10
# 1  大阪  ノート  3500   7
# 2  東京  ノート  4200  12
# 3  大阪   ペン  2800  20
isin(["ペン", "ノート"])は、商品名が指定したリストのいずれかに一致する行を判定します。
対象を増やす場合はリストに候補を追加するだけです。
isin()も完全一致であり、部分一致を検索するstr.contains()とは役割が異なります。
条件に合う行と必要な列を同時に取り出す
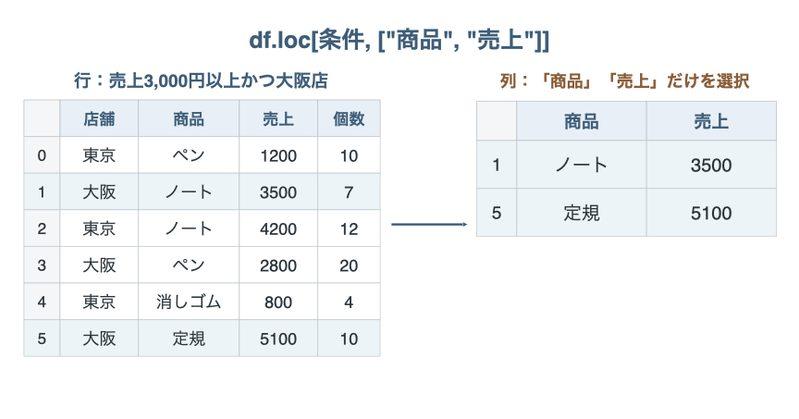
ここまでは、条件に合う行を選び、元の列をすべて残していました。
例えば「大阪店で売上3,000円以上の行から、商品と売上だけを確認したい」場合は、locを使います。
result = df.loc[
    (df["売上"] >= 3000) & (df["店舗"] == "大阪"),
    ["商品", "売上"],
]
print(result)

# 実行結果:
#     商品    売上
# 1  ノート  3500
# 5   定規  5100
df.loc[行の条件, 列名のリスト]と書くと、行を条件で絞り込みながら、必要な列だけを選択できます。
locの基本やilocとの違いは、こちらの記事で詳しく解説しています。
条件抽出でよくある間違い
andやorを使ってしまう: pandasのSeriesを組み合わせるときは&と|を使い、条件ごとに丸括弧を付けます。=と==を混同する: 値が等しいか調べる場合は==を使います。- 数値が文字列になっている: CSVから読んだ「売上」列が文字列の場合、数値との比較に失敗することがあります。
df.dtypesで確認してから数値型へ変換します。 - 抽出後のインデックスを0から始まると考える: 行を取り出しても元のインデックスが残ります。
条件抽出だけでは元のdfは書き換わりません。
抽出結果を別の表として加工したい場合は、次のように明示的にコピーしておくと扱いやすくなります。
filtered_copy = df.loc[df["売上"] >= 3000].copy()
print(filtered_copy.index.tolist())
print(df.shape)

# 実行結果:
# [1, 2, 5]
# (6, 4)filtered_copyには3行が入りますが、元のdfは6行4列のままです。
抽出後のデータに新しい列を追加するなどの処理をする場合にも、.copy()を使うと元データとの関係が明確になります。
pandas入門書の紹介
この記事では、数値・文字列による条件抽出から、複数条件、isin()、列の選択までを学びました。
実際のデータ分析では、こうした抽出操作と、CSV・Excelの読み込み、欠損値の処理、集計、保存などを組み合わせることになります。
これらを基礎から体系的に学びたい方に向けて、Kindle書籍**『機械学習・データ分析のためのpandas入門 ― データ加工と集計の基本をPythonで学ぶ ―』**(著者:ぼりたそ)を執筆しました。
本書では、Series・DataFrameの基本からデータの読み込み・加工・集計・結合まで、図解やコード例、演習を通じて順番に学べます。
ブログで操作を一つずつ確認し、書籍でデータ処理全体の流れを身に付けたい方におすすめです。
まとめ
今回は、pandasで条件に合うデータを抽出する方法を解説しました。
df[条件式]で、条件がTrueになった行だけを取り出せます。==・>=などの比較演算子で、数値や文字列を条件にできます。- 複数条件では
&(AND)・|(OR)・~(NOT)を使い、条件を丸括弧で囲みます。 isin()を使うと、複数候補のいずれかに一致する行を抽出できます。df.loc[条件, 列名]で、行の絞り込みと列の選択を組み合わせられます。
まずは今回の6行のデータを使って、数値や店舗名、商品の候補を変えながら抽出結果を確認してみてください。